C++ TinyWebServer项目实践

项目简介

源-项目地址: qinguoyi/TinyWebServer: Linux下C++轻量级Web服务器学习 (github.com)

Linux下C++轻量级Web服务器,助力初学者快速实践网络编程,搭建属于自己的服务器.

  • 使用 线程池 + 非阻塞socket + epoll(ET和LT均实现) + 事件处理(Reactor和模拟Proactor均实现) 的并发模型
  • 使用状态机解析HTTP请求报文,支持解析GET和POST请求
  • 访问服务器数据库实现web端用户注册、登录功能,可以请求服务器图片和视频文件
  • 实现同步/异步日志系统,记录服务器运行状态
  • 经Webbench压力测试可以实现上万的并发连接数据交换

大纲

1. 什么是Web Server(网络服务器)?

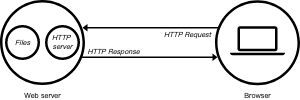
一个Web Server就是一个服务器软件(程序),或者是运行这个服务器软件的硬件(计算机)。其主要功能是通过HTTP协议与客户端(通常是浏览器(Browser))进行通信,来接收,存储,处理来自客户端的HTTP请求,并对其请求做出HTTP响应,返回给客户端其请求的内容(文件、网页等)或返回一个Error信息。

2. 用户如何与你的Web服务器进行通信?

通常用户使用Web浏览器与相应服务器进行通信。在浏览器中键入“域名”或“IP地址:端口号”,浏览器则先将你的域名解析成相应的IP地址或者直接根据你的IP地址向对应的Web服务器发送一个HTTP请求。这一过程首先要通过TCP协议的三次握手建立与目标Web服务器的连接,然后HTTP协议生成针对目标Web服务器的HTTP请求报文,通过TCP、IP等协议发送到目标Web服务器上。

3. Web服务器如何接收客户端发来的HTTP请求报文呢?

什么是socket?

Web服务器端通过socket监听来自用户的请求。

#include <sys/socket.h>  
#include <netinet/in.h>
/* 创建监听socket文件描述符 */
int listenfd = socket(PF_INET, SOCK_STREAM, 0);
/* 创建监听socket的TCP/IP的IPV4 socket地址 */
struct sockaddr_in address;
bzero(&address, sizeof(address));
address.sin_family = AF_INET;
address.sin_addr.s_addr = htonl(INADDR_ANY); /* INADDR_ANY:将套接字绑定到所有可用的接口 */
address.sin_port = htons(port);

int flag = 1;
/* SO_REUSEADDR 允许端口被重复使用 */
setsockopt(listenfd, SOL_SOCKET, SO_REUSEADDR, &flag, sizeof(flag));
/* 绑定socket和它的地址 */
ret = bind(listenfd, (struct sockaddr*)&address, sizeof(address));
/* 创建监听队列以存放待处理的客户连接,在这些客户连接被accept()之前 */
ret = listen(listenfd, 5);

远端的很多用户会尝试去connect()这个Web Server上正在listen的这个port,而监听到的这些连接会排队等待被accept()。由于用户连接请求是随机到达的异步事件,每当监听socket(listenfd)listen到新的客户连接并且放入监听队列,我们都需要告诉我们的Web服务器有连接来了,accept这个连接,并分配一个逻辑单元来处理这个用户请求。

什么是EPOLL I/O复用?

参考: 浅谈Linux IO复用 - 知乎 (zhihu.com)

IO复用(I/O Multiplexing)通俗的来说:是同时处理多个描述符IO事件的一种技术手段。这些文件描述符包括:socket套接字、普通文件、设备文件等。

举个简单例子:tcp server同时处理两个文件描述符,一个是标准输入,一个是tcp连接。当server接收标准输入时,可能会因调用fgets()而阻塞,从而无法及时处理另一个tcp连接的可读事件,比如有tcp client发送了数据。

如果tcp server想要同时处理多个描述符的事件,可能的做法是开启多个线程或进程,各自等待描述符的可读可写事件,但这样一来,就需要引入线程间同步和通信问题,大大增加编程的复杂性。

但IO复用技术的出现,可以很好的解决上述问题,它直接管理多个描述符,选出IO事件ready的描述符列表。这种操作方式允许应用程序以较低的成本、较高的效率,同时管理多个描述符的IO事件。

我们在处理用户请求的同时,还需要继续监听其他客户的请求并分配其另一逻辑单元来处理(并发,同时处理多个事件,后面会提到使用线程池实现并发)。这里,服务器通过epoll这种I/O复用技术(还有select和poll)来实现对监听socket(listenfd)和连接socket(客户请求)的同时监听。 注意I/O复用虽然可以同时监听多个文件描述符,但是它本身是阻塞的,并且当有多个文件描述符同时就绪的时候,如果不采取额外措施,程序则只能按顺序处理其中就绪的每一个文件描述符,所以为提高效率,我们将在这部分通过线程池来实现并发(多线程并发),为每个就绪的文件描述符分配一个逻辑单元(线程)来处理。

服务器程序通常需要处理三类事件:I/O事件,信号及定时事件。有两种事件处理模式:

  • Reactor模式:要求主线程(I/O处理单元)只负责监听文件描述符上是否有事件发生(可读、可写),若有,则立即通知工作线程(逻辑单元),将socket可读可写事件放入请求队列,交给工作线程处理。
  • Proactor模式:将所有的I/O操作都交给主线程和内核来处理(进行读、写),工作线程仅负责处理逻辑,如主线程读完成后users[sockfd].read(),选择一个工作线程来处理客户请求pool->append(users + sockfd)。

通常使用同步I/O模型(如epoll_wait)实现Reactor,使用异步I/O(如aio_read和aio_write)实现Proactor。在此项目中,我们使用的是同步I/O模拟的Proactor事件处理模式。

Linux下有三种IO复用方式:epoll,select和poll,为什么用epoll,它和其他两个有什么区别呢?

  • 对于select和poll来说,所有文件描述符都是在用户态被加入其文件描述符集合的,每次调用都需要将整个集合拷贝到内核态;epoll则将整个文件描述符集合维护在内核态,每次添加文件描述符的时候都需要执行一个系统调用。系统调用的开销是很大的,而且在有很多短期活跃连接的情况下,epoll可能会慢于select和poll由于这些大量的系统调用开销。
  • select使用线性表描述文件描述符集合,文件描述符有上限;poll使用链表来描述;epoll底层通过红黑树来描述,并且维护一个ready list,将事件表中已经就绪的事件添加到这里,在使用epoll_wait调用时,仅观察这个list中有没有数据即可。
  • select和poll的最大开销来自内核判断是否有文件描述符就绪这一过程:每次执行select或poll调用时,它们会采用遍历的方式,遍历整个文件描述符集合去判断各个文件描述符是否有活动;epoll则不需要去以这种方式检查,当有活动产生时,会自动触发epoll回调函数通知epoll文件描述符,然后内核将这些就绪的文件描述符放到之前提到的ready list中等待epoll_wait调用后被处理。
  • select和poll都只能工作在相对低效的LT模式下,而epoll同时支持LT和ET模式。
  • 综上,当监测的fd数量较小,且各个fd都很活跃的情况下,建议使用select和poll;当监听的fd数量较多,且单位时间仅部分fd活跃的情况下,使用epoll会明显提升性能。

从工作原理中,也可以看出select与epoll的诸多不同,
优缺点对比如下:

  • 支持监听的描述符数量
  • select支持的描述符数量受限:因为需要遍历描述符列表、多次用户空间到内核空间的内存拷贝。
  • epoll可以支撑监听海量的描述符。
    性能
  • select随着描述符数量的增多,性能下降严重,时间复杂度 > O(n)。
  • epoll通过回调函数的方式,在描述符增长的情况下,依旧有出色的性能。
    使用场景
  • select使用方式较为简单,适用于描述符量级小的情况。
  • epoll适用于同时监听大量的描述符。

Epoll对文件操作符的操作有两种模式:LT(电平触发)和ET(边缘触发),二者的区别?

  • LT(水平触发,默认):当时间发生时,如果用户不处理的话,内核会一直通知此事件。
  • ET(垂直触发):只有当事件状态发生改变时,内核才会通知。(如果描述符缓冲区还有未处理的数据,内核下次不会再通知了,因为状态没有发生改变)

4. Web服务器如何处理以及响应接收到的HTTP请求报文呢?

参考: C++ 线程池 - 敬方的个人博客 | BY Blog (wangpengcheng.github.io)

该项目使用线程池(半同步半反应堆模式)并发处理用户请求,主线程负责读写,工作线程(线程池中的线程)负责处理逻辑(HTTP请求报文的解析等等)。 通过之前的代码,我们将listenfd上到达的connection通过 accept()接收,并返回一个新的socket文件描述符connfd用于和用户通信,并对用户请求返回响应,同时将这个connfd注册到内核事件表中,等用户发来请求报文。

什么是线程池?

这个过程是:通过epoll_wait发现这个connfd上有可读事件了(EPOLLIN),主线程就将这个HTTP的请求报文读进这个连接socket的读缓存中users[sockfd].read(),然后将该任务对象(指针)插入线程池的请求队列中pool->append(users + sockfd);,线程池的实现还需要依靠锁机制以及信号量机制来实现线程同步,保证操作的原子性。

  • 所谓线程池,就是一个pthread_t类型的普通数组,通过pthread_create()函数创建m_thread_number个线程,用来执行worker()函数以执行每个请求处理函数(HTTP请求的process函数),通过pthread_detach()将线程设置成脱离态(detached)后,当这一线程运行结束时,它的资源会被系统自动回收,而不再需要在其它线程中对其进行 pthread_join() 操作。
  • 操作工作队列一定要加锁(locker),因为它被所有线程共享。
  • 我们用信号量来标识请求队列中的请求数,通过m_queuestat.wait();来等待一个请求队列中待处理的HTTP请求,然后交给线程池中的空闲线程来处理。

为什么要使用线程池?

当你需要限制你应用程序中同时运行的线程数时,线程池非常有用。因为启动一个新线程会带来性能开销,每个线程也会为其堆栈分配一些内存等。为了任务的并发执行,我们可以将这些任务任务传递到线程池,而不是为每个任务动态开启一个新的线程。

关于HTTP请求?

本项目中的HTTP请求的入口函数:

void http_conn::process() {  
HTTP_CODE read_ret = process_read();
if(read_ret == NO_REQUEST) {
modfd(m_epollfd, m_sockfd, EPOLLIN);
return;
}
bool write_ret = process_write(read_ret);
if(!write_ret)
close_conn();
modfd(m_epollfd, m_sockfd, EPOLLOUT);
}

HTTP请求报文由请求行(request line)、请求头部(header)、空行和请求数据四个部分组成有。两种请求报文

  • GET(Example)

    GET /562f25980001b1b106000338.jpg HTTP/1.1  
    Host:img.mukewang.com
    User-Agent:Mozilla/5.0 (Windows NT 10.0; WOW64)
    AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.106 Safari/537.36
    Accept:image/webp,image/*,*/*;q=0.8
    Referer:[http://www.imooc.com/](http://www.imooc.com/)
    Accept-Encoding:gzip, deflate, sdch
    Accept-Language:zh-CN,zh;q=0.8
    空行
    请求数据为空
  • POST(Example,注意POST的请求内容不为空)

    POST / HTTP1.1  
    Host:www.wrox.com
    User-Agent:Mozilla/4.0 (compatible; MSIE 6.0; Windows NT 5.1; SV1; .NET CLR 2.0.50727; .NET CLR 3.0.04506.648; .NET CLR 3.5.21022)
    Content-Type:application/x-www-form-urlencoded
    Content-Length:40
    Connection: Keep-Alive
    空行
    name=Professional%20Ajax&publisher=Wiley

GET和POST的区别

  • 最直观的区别就是GET把参数包含在URL中,POST通过request body传递参数。
  • GET请求参数会被完整保留在浏览器历史记录里,而POST中的参数不会被保留。
  • GET请求在URL中传送的参数是有长度限制。(大多数)浏览器通常都会限制url长度在2K个字节,而(大多数)服务器最多处理64K大小的url。
  • GET产生一个TCP数据包;POST产生两个TCP数据包。对于GET方式的请求,浏览器会把http header和data一并发送出去,服务器响应200(返回数据);而对于POST,浏览器先发送header,服务器响应100(指示信息—表示请求已接收,继续处理)continue,浏览器再发送data,服务器响应200 ok(返回数据)。

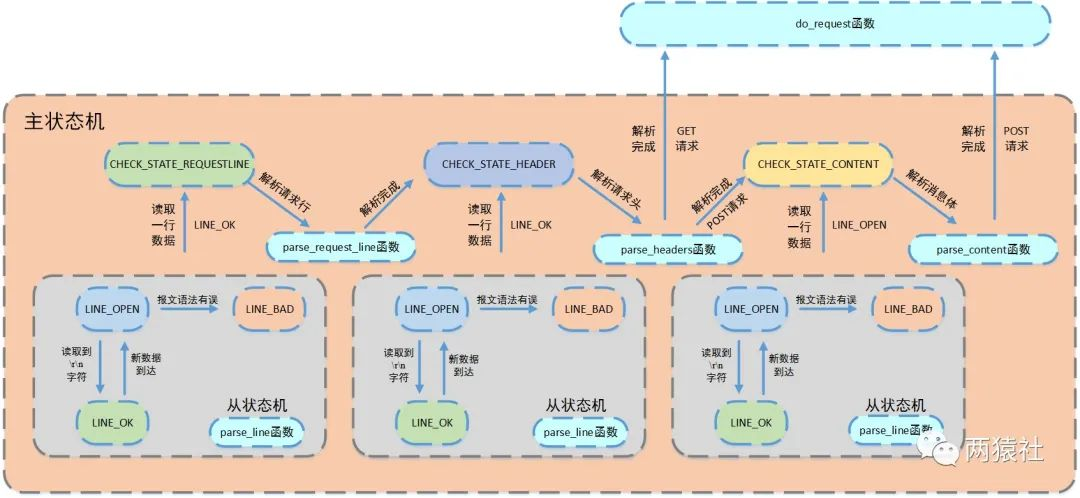
process_read()函数的作用就是将类似上述例子的请求报文进行解析,因为用户的请求内容包含在这个请求报文里面,只有通过解析,知道用户请求的内容是什么,是请求图片,还是视频,或是其他请求,我们根据这些请求返回相应的HTML页面等。项目中使用主从状态机的模式进行解析,从状态机(parse_line)负责读取报文的一行,主状态机负责对该行数据进行解析,主状态机内部调用从状态机,从状态机驱动主状态机。每解析一部分都会将整个请求的m_check_state状态改变,状态机也就是根据这个状态来进行不同部分的解析跳转的:

  • parse_request_line(text),解析请求行,也就是GET中的GET /562f25980001b1b106000338.jpg HTTP/1.1这一行,或者POST中的POST / HTTP1.1这一行。通过请求行的解析我们可以判断该HTTP请求的类型(GET/POST),而请求行中最重要的部分就是URL部分,我们会将这部分保存下来用于后面的生成HTTP响应。
  • parse_headers(text);,解析请求头部,GET和POST中空行以上,请求行以下的部分。
  • parse_content(text);,解析请求数据,对于GET来说这部分是空的,因为这部分内容已经以明文的方式包含在了请求行中的URL部分了;只有POST的这部分是有数据的,项目中的这部分数据为用户名和密码,我们会根据这部分内容做登录和校验,并涉及到与数据库的连接。

5. 数据库连接池是如何运行的?

在处理用户注册,登录请求的时候,我们需要将这些用户的用户名和密码保存下来用于新用户的注册及老用户的登录校验,这种功能是服务器端通过用户键入的用户名密码和数据库中已记录下来的用户名密码数据进行校验实现的。若每次用户请求我们都需要新建一个数据库连接,请求结束后我们释放该数据库连接,当用户请求连接过多时,这种做法过于低效,所以类似线程池的做法,我们构建一个数据库连接池,预先生成一些数据库连接放在那里供用户请求使用。

我们首先看单个数据库连接是如何生成的:

  1. 使用mysql_init()初始化连接
  2. 使用mysql_real_connect()建立一个到mysql数据库的连接
  3. 使用mysql_query()执行查询语句
  4. 使用result = mysql_store_result(mysql)获取结果集
  5. 使用mysql_num_fields(result)获取查询的列数,mysql_num_rows(result)获取结果集的行数
  6. 通过mysql_fetch_row(result)不断获取下一行,然后循环输出
  7. 使用mysql_free_result(result)释放结果集所占内存
  8. 使用mysql_close(conn)关闭连接

对于一个数据库连接池来讲,就是预先生成多个这样的数据库连接,然后放在一个链表中,同时维护最大连接数MAX_CONN,当前可用连接数FREE_CONN和当前已用连接数CUR_CONN这三个变量。同样注意在对连接池操作时(获取,释放),要用到锁机制,因为它被所有线程共享。

6. 什么是CGI校验?

OK,弄清楚了数据库连接池的概念及实现方式,我们继续回到第4部分,对用户的登录及注册等POST请求,服务器是如何做校验的

CGI(通用网关接口),它是一个运行在Web服务器上的程序,在编译的时候将相应的.cpp文件编程成.cgi文件并在主程序中调用即可(通过社长的makefile文件内容也可以看出)。这些CGI程序通常通过客户在其浏览器上点击一个button时运行。这些程序通常用来执行一些信息搜索、存储等任务,而且通常会生成一个动态的HTML网页来响应客户的HTTP请求。我们可以发现项目中的sign.cpp文件就是我们的CGI程序,将用户请求中的用户名和密码保存在一个id_passwd.txt文件中,通过将数据库中的用户名和密码存到一个map中用于校验。在主程序中通过execl(m_real_file, &flag, name, password, NULL);这句命令来执行这个CGI文件,这里CGI程序仅用于校验,并未直接返回给用户响应。这个CGI程序的运行通过多进程来实现,根据其返回结果判断校验结果(使用pipe进行父子进程的通信,子进程将校验结果写到pipe的写端,父进程在读端读取)。

7. 如何生成HTTP响应并返回给用户?

通过以上操作,我们已经对读到的请求做好了处理,然后也对目标文件的属性作了分析,若目标文件存在、对所有用户可读且不是目录时,则使用mmap将其映射到内存地址m_file_address处,并告诉调用者获取文件成功FILE_REQUEST。 接下来要做的就是根据读取结果对用户做出响应了,也就是到了process_write(read_ret);这一步,该函数根据process_read()的返回结果来判断应该返回给用户什么响应,我们最常见的就是404错误了,说明客户请求的文件不存在,除此之外还有其他类型的请求出错的响应,具体的可以去百度。然后呢,假设用户请求的文件存在,而且已经被mmap到m_file_address这里了,那么我们就将做如下写操作,将响应写到这个connfd的写缓存m_write_buf中去

case FILE_REQUEST: {  
add_status_line(200, ok_200_title);
if(m_file_stat.st_size != 0) {
add_headers(m_file_stat.st_size);
m_iv[0].iov_base = m_write_buf;
m_iv[0].iov_len = m_write_idx;
m_iv[1].iov_base = m_file_address;
m_iv[1].iov_len = m_file_stat.st_size;
m_iv_count = 2;
bytes_to_send = m_write_idx + m_file_stat.st_size;
return true;
}
else {
const char* ok_string = "<html><body></body></html>";
add_headers(strlen(ok_string));
if(!add_content(ok_string))
return false;
}
}

00 Linux网络开发环境搭建

MacOS虽然也是UNIX操作系统, 但本项目中的许多库函数在Mac下并未得到支持, 所以本次项目使用Docker下的虚拟环境进行开发.

#macos
docker pull centos
docker -it run centos

#centos container
yum update -y
yum install gcc-c++
yum install mysql
yum install mysql-server

ln -s /usr/lib64/libmysqlclient.so /usr/lib/libmysqlclient.so

01 线程同步机制封装类

C++的RSII机制

  • RAII全称是“Resource Acquisition is Initialization”,直译过来是“资源获取即初始化”.
  • 在构造函数中申请分配资源,在析构函数中释放资源。因为C++的语言机制保证了,当一个对象创建的时候,自动调用构造函数,当对象超出作用域的时候会自动调用析构函数。所以,在RAII的指导下,我们应该使用类来管理资源,将资源和对象的生命周期绑定
  • RAII的核心思想是将资源或者状态与对象的生命周期绑定,通过C++的语言机制,实现资源和状态的安全管理,智能指针是RAII最好的例子

Linux中的条件变量

linux中的条件变量的使用-CSDN博客

条件变量提供了一种线程间的通知机制,当某个共享数据达到某个值时,唤醒等待这个共享数据的线程.

  • pthread_cond_init函数用于初始化条件变量

  • pthread_cond_destory函数销毁条件变量

  • pthread_cond_broadcast函数以广播的方式唤醒所有等待目标条件变量的线程

  • pthread_cond_wait函数用于等待目标条件变量.该函数调用时需要传入 mutex参数(加锁的互斥锁) ,函数执行时,先把调用线程放入条件变量的请求队列,然后将互斥锁mutex解锁,当函数成功返回为0时,互斥锁会再次被锁上. 也就是说函数内部会有一次解锁和加锁操作.

Linux中的互斥量

Linux线程-互斥锁-CSDN博客

互斥锁,也成互斥量,可以保护关键代码段,以确保独占式访问.当进入关键代码段,获得互斥锁将其加锁;离开关键代码段,唤醒等待该互斥锁的线程.

  • pthread_mutex_init函数用于初始化互斥锁

  • pthread_mutex_destory函数用于销毁互斥锁

  • pthread_mutex_lock函数以原子操作方式给互斥锁加锁

  • pthread_mutex_unlock函数以原子操作方式给互斥锁解锁

以上,成功返回0,失败返回errno

Linux中的信号量

信号量是一种特殊的变量,它只能取自然数值并且只支持两种操作:等待(P)和信号(V).假设有信号量SV,对其的P、V操作如下:

  • P,如果SV的值大于0,则将其减一;若SV的值为0,则挂起执行
  • V,如果有其他进行因为等待SV而挂起,则唤醒;若没有,则将SV值加一

信号量的取值可以是任何自然数,最常用的,最简单的信号量是二进制信号量,只有0和1两个值.

  • sem_init函数用于初始化一个未命名的信号量

  • sem_destory函数用于销毁信号量

  • sem_wait函数将以原子操作方式将信号量减一,信号量为0时,sem_wait阻塞

  • sem_post函数以原子操作方式将信号量加一,信号量大于0时,唤醒调用sem_post的线程

以上,成功返回0,失败返回errno

02 数据库连接池

什么是数据库连接池?

池是一组资源的集合,这组资源在服务器启动之初就被完全创建好并初始化。通俗来说,池是资源的容器,本质上是对资源的复用。

顾名思义,连接池中的资源为一组数据库连接,由程序动态地对池中的连接进行使用,释放。

当系统开始处理客户请求的时候,如果它需要相关的资源,可以直接从池中获取,无需动态分配;当服务器处理完一个客户连接后,可以把相关的资源放回池中,无需执行系统调用释放资源。

数据库访问的一般流程是什么?

当系统需要访问数据库时,先系统创建数据库连接,完成数据库操作,然后系统断开数据库连接。

为什么要创建连接池?

从一般流程中可以看出,若系统需要频繁访问数据库,则需要频繁创建和断开数据库连接,而创建数据库连接是一个很耗时的操作,也容易对数据库造成安全隐患。

在程序初始化的时候,集中创建多个数据库连接,并把他们集中管理,供程序使用,可以保证较快的数据库读写速度,更加安全可靠。

数据库连接池

池可以看做资源的容器,所以多种实现方法,比如数组、链表、队列等。这里,使用单例模式和链表创建数据库连接池,实现对数据库连接资源的复用。

项目中的数据库模块分为两部分,其一是数据库连接池的定义,其二是利用连接池完成登录和注册的校验功能。具体的,工作线程从数据库连接池取得一个连接,访问数据库中的数据,访问完毕后将连接交还连接池。

单例模式创建,结合代码描述连接池的单例实现。

连接池代码实现,结合代码对连接池的外部访问接口进行详解。

RAII机制释放数据库连接,描述连接释放的封装逻辑。

数据库连接池

  • 单例模式,保证唯一
  • list实现连接池
  • 连接池为静态大小
  • 互斥锁实现线程安全
  • connectionRAII类
class connectionRAII{
public:
connectionRAII(MYSQL **con, connection_pool *connPool);
~connectionRAII();

private:
MYSQL *conRAII;
connection_pool *poolRAII;

};

目的是实现connction的自动连接与释放, 以下显示了connectionRAII在用户代码是如何被使用, 起到了怎样的效果

//引入RAII类前: 用户代码中需要手动获得和释放连接
//从连接池中取出一个数据库连接
request->mysql = m_connPool->GetConnection();
//process(模板类中的方法,这里是http类)进行处理
request->process();
//将数据库连接放回连接池
m_connPool->ReleaseConnection(request->mysql);

//引入RAII类之后: 连接不使用可以被自动释放
connectionRAII mysqlcon(&request->mysql, m_connPool);
request->process();

03 半同步半反应堆线程池

服务器编程基本框架

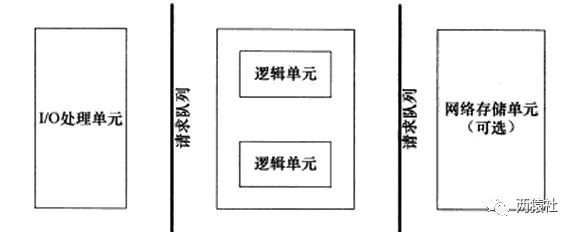
主要由I/O单元,逻辑单元和网络存储单元组成,其中每个单元之间通过请求队列进行通信,从而协同完成任务。

其中I/O单元用于处理客户端连接,读写网络数据;逻辑单元用于处理业务逻辑的线程;网络存储单元指本地数据库和文件等。

五种I/O模型

  • 阻塞IO:调用者调用了某个函数,等待这个函数返回,期间什么也不做,不停的去检查这个函数有没有返回,必须等这个函数返回才能进行下一步动作

  • 非阻塞IO:非阻塞等待,每隔一段时间就去检测IO事件是否就绪。没有就绪就可以做其他事。非阻塞I/O执行系统调用总是立即返回,不管时间是否已经发生,若时间没有发生,则返回-1,此时可以根据errno区分这两种情况,对于accept,recv和send,事件未发生时,errno通常被设置成eagain

  • 信号驱动IO:linux用套接口进行信号驱动IO,安装一个信号处理函数,进程继续运行并不阻塞,当IO时间就绪,进程收到SIGIO信号。然后处理IO事件。

  • IO复用:linux用select/poll函数实现IO复用模型,这两个函数也会使进程阻塞,但是和阻塞IO所不同的是这两个函数可以同时阻塞多个IO操作。而且可以同时对多个读操作、写操作的IO函数进行检测。知道有数据可读或可写时,才真正调用IO操作函数

  • 异步IO:linux中,可以调用aio_read函数告诉内核描述字缓冲区指针和缓冲区的大小、文件偏移及通知的方式,然后立即返回,当内核将数据拷贝到缓冲区后,再通知应用程序。

事件处理模式

  • reactor模式中,主线程(I/O处理单元)只负责监听文件描述符上是否有事件发生,有的话立即通知工作线程(逻辑单元 ),读写数据、接受新连接及处理客户请求均在工作线程中完成。通常由同步I/O实现。

  • proactor模式中,主线程和内核负责处理读写数据、接受新连接等I/O操作,工作线程仅负责业务逻辑,如处理客户请求。通常由异步I/O实现。

同步I/O模拟proactor模式

由于异步I/O并不成熟,实际中使用较少,这里将使用同步I/O模拟实现proactor模式。

同步I/O模型的工作流程如下(epoll_wait为例):

  • 主线程往epoll内核事件表注册socket上的读就绪事件。

  • 主线程调用epoll_wait等待socket上有数据可读

  • 当socket上有数据可读,epoll_wait通知主线程,主线程从socket循环读取数据,直到没有更多数据可读,然后将读取到的数据封装成一个请求对象并插入请求队列。

  • 睡眠在请求队列上某个工作线程被唤醒,它获得请求对象并处理客户请求,然后往epoll内核事件表中注册该socket上的写就绪事件

  • 主线程调用epoll_wait等待socket可写。

  • 当socket上有数据可写,epoll_wait通知主线程。主线程往socket上写入服务器处理客户请求的结果。

并发编程模式

并发编程方法的实现有多线程和多进程两种,但这里涉及的并发模式指I/O处理单元与逻辑单元的协同完成任务的方法。

  • 半同步/半异步模式

  • 领导者/追随者模式

半同步/半反应堆并发模式是半同步/半异步的变体,将半异步具体化为某种事件处理模式.

并发模式中的同步和异步

  • 同步指的是程序完全按照代码序列的顺序执行

  • 异步指的是程序的执行需要由系统事件驱动

半同步/半异步模式工作流程

  • 同步线程用于处理客户逻辑

  • 异步线程用于处理I/O事件

  • 异步线程监听到客户请求后,就将其封装成请求对象并插入请求队列中

  • 请求队列将通知某个工作在同步模式的工作线程来读取并处理该请求对象

半同步/半反应堆工作流程(以Proactor模式为例)

  • 主线程充当异步线程,负责监听所有socket上的事件

  • 若有新请求到来,主线程接收之以得到新的连接socket,然后往epoll内核事件表中注册该socket上的读写事件

  • 如果连接socket上有读写事件发生,主线程从socket上接收数据,并将数据封装成请求对象插入到请求队列中

  • 所有工作线程(线程池)睡眠在请求队列上,当有任务到来时,通过竞争(如互斥锁)获得任务的接管权

线程池

  • 空间换时间,牺牲服务器的硬件资源,换取运行效率.

  • 池是一组资源的集合,这组资源在服务器启动之初就被完全创建好并初始化,这称为静态资源.

  • 当服务器进入正式运行阶段,开始处理客户请求的时候,如果它需要相关的资源,可以直接从池中获取,无需动态分配.

  • 当服务器处理完一个客户连接后,可以把相关的资源放回池中,无需执行系统调用释放资源.

静态成员变量

将类成员变量声明为static,则为静态成员变量,与一般的成员变量不同,无论建立多少对象,都只有一个静态成员变量的拷贝,静态成员变量属于一个类,所有对象共享。

静态变量在编译阶段就分配了空间,对象还没创建时就已经分配了空间,放到全局静态区。

  • 最好是类内声明,类外初始化(以免类名访问静态成员访问不到)。

  • 无论公有,私有,静态成员都可以在类外定义,但私有成员仍有访问权限。

  • 非静态成员类外不能初始化。

  • 静态成员数据是共享的。

静态成员函数

将类成员函数声明为static,则为静态成员函数。

  • 静态成员函数可以直接访问静态成员变量,不能直接访问普通成员变量,但可以通过参数传递的方式访问。

  • 普通成员函数可以访问普通成员变量,也可以访问静态成员变量。

  • 静态成员函数没有this指针。非静态数据成员为对象单独维护,但静态成员函数为共享函数,无法区分是哪个对象,因此不能直接访问普通变量成员,也没有this指针。

pthread_create陷阱

static void *worker(void *args);

pthread_create(m_threads[i], NULL, worker, this)!=0

首先看一下该函数的函数原型。
pthread_create()函数:创建线程 (biancheng.net)

int pthread_create(pthread_t *thread,
const pthread_attr_t *attr,
void *(*start_routine) (void *),
void *arg);
pthread_create(m_threads[i], NULL, worker, this)!=0
//本质上工作线程的内容还是threadpool<T>::run()
template <typename T>
void *threadpool<T>::worker(void *arg)
{
threadpool *pool = (threadpool *)arg;
pool->run();
return pool;
}

函数原型中的第三个参数,为函数指针,指向处理线程函数的地址。该函数,要求为静态函数。如果处理线程函数为类成员函数时,需要将其设置为静态成员函数。
pthread_create的函数原型中第三个参数的类型为函数指针,指向的线程处理函数参数类型为(void *),若线程函数为类成员函数,则this指针会作为默认的参数被传进函数中,从而和线程函数参数(void*)不能匹配,不能通过编译。

静态成员函数就没有这个问题,里面没有this指针。

线程池设计

使用一个工作队列完全解除了主线程和工作线程的耦合关系:主线程往工作队列中插入任务,工作线程通过竞争来取得任务并执行它。

  • 同步I/O模拟proactor模式
  • 半同步/半反应堆
  • 线程池

线程池的设计模式为半同步/半反应堆,其中反应堆具体为Proactor事件处理模式。

具体的,主线程为异步线程,负责监听文件描述符,接收socket新连接,若当前监听的socket发生了读写事件,然后将任务插入到请求队列。工作线程从请求队列中取出任务,完成读写数据的处理。

04 HTTP连接处理

IO复用

一文看懂IO多路复用 - 知乎 (zhihu.com)
《Linux高性能服务器编程》第九章 I/O复用-CSDN博客

epoll涉及的知识较多,这里仅对API和基础知识作介绍。更多资料请查阅资料,或查阅游双的Linux高性能服务器编程 第9章 I/O复用

epoll_create函数

#include <sys/epoll.h>
int epoll_create(int size)

创建一个指示epoll内核事件表的文件描述符,该描述符将用作其他epoll系统调用的第一个参数,size不起作用。

epoll_ctl函数

#include <sys/epoll.h>
int epoll_ctl(int epfd, int op, int fd, struct epoll_event *event)

该函数用于操作内核事件表监控的文件描述符上的事件:注册、修改、删除

  • epfd:为epoll_creat的句柄

  • op:表示动作,用3个宏来表示:

  • EPOLL_CTL_ADD (注册新的fd到epfd),

  • EPOLL_CTL_MOD (修改已经注册的fd的监听事件),

  • EPOLL_CTL_DEL (从epfd删除一个fd);

  • event:告诉内核需要监听的事件

上述event是epoll_event结构体指针类型,表示内核所监听的事件,具体定义如下:

struct epoll_event {
__uint32_t events; /* Epoll events */
epoll_data_t data; /* User data variable */};
  • events描述事件类型,其中epoll事件类型有以下几种

  • EPOLLIN:表示对应的文件描述符可以读(包括对端SOCKET正常关闭)

  • EPOLLOUT:表示对应的文件描述符可以写

  • EPOLLPRI:表示对应的文件描述符有紧急的数据可读(这里应该表示有带外数据到来)

  • EPOLLERR:表示对应的文件描述符发生错误

  • EPOLLHUP:表示对应的文件描述符被挂断;

  • EPOLLET:将EPOLL设为边缘触发(Edge Triggered)模式,这是相对于水平触发(Level Triggered)而言的

  • EPOLLONESHOT:只监听一次事件,当监听完这次事件之后,如果还需要继续监听这个socket的话,需要再次把这个socket加入到EPOLL队列里

epoll_wait函数

#include <sys/epoll.h>
int epoll_wait(int epfd, struct epoll_event *events, int maxevents, int timeout)

该函数用于等待所监控文件描述符上有事件的产生,返回就绪的文件描述符个数

  • events:用来存内核得到事件的集合,

  • maxevents:告之内核这个events有多大,这个maxevents的值不能大于创建epoll_create()时的size,

  • timeout:是超时时间

  • -1:阻塞

  • 0:立即返回,非阻塞

  • 0:指定毫秒

  • 返回值:成功返回有多少文件描述符就绪,时间到时返回0,出错返回-1

select/poll/epoll

  • 调用函数

  • select和poll都是一个函数,epoll是一组函数

  • 文件描述符数量

  • select通过线性表描述文件描述符集合,文件描述符有上限,一般是1024,但可以修改源码,重新编译内核,不推荐

  • poll是链表描述,突破了文件描述符上限,最大可以打开文件的数目

  • epoll通过红黑树描述,最大可以打开文件的数目,可以通过命令ulimit -n number修改,仅对当前终端有效

  • 将文件描述符从用户传给内核

  • select和poll通过将所有文件描述符拷贝到内核态,每次调用都需要拷贝

  • epoll通过epoll_create建立一棵红黑树,通过epoll_ctl将要监听的文件描述符注册到红黑树上

  • 内核判断就绪的文件描述符

  • select和poll通过遍历文件描述符集合,判断哪个文件描述符上有事件发生

  • epoll_create时,内核除了帮我们在epoll文件系统里建了个红黑树用于存储以后epoll_ctl传来的fd外,还会再建立一个list链表,用于存储准备就绪的事件,当epoll_wait调用时,仅仅观察这个list链表里有没有数据即可。

  • epoll是根据每个fd上面的回调函数(中断函数)判断,只有发生了事件的socket才会主动的去调用 callback函数,其他空闲状态socket则不会,若是就绪事件,插入list

  • 应用程序索引就绪文件描述符

  • select/poll只返回发生了事件的文件描述符的个数,若知道是哪个发生了事件,同样需要遍历

  • epoll返回的发生了事件的个数和结构体数组,结构体包含socket的信息,因此直接处理返回的数组即可

  • 工作模式

  • select和poll都只能工作在相对低效的LT模式下

  • epoll则可以工作在ET高效模式,并且epoll还支持EPOLLONESHOT事件,该事件能进一步减少可读、可写和异常事件被触发的次数。 

  • 应用场景

  • 当所有的fd都是活跃连接,使用epoll,需要建立文件系统,红黑书和链表对于此来说,效率反而不高,不如selece和poll

  • 当监测的fd数目较小,且各个fd都比较活跃,建议使用select或者poll

  • 当监测的fd数目非常大,成千上万,且单位时间只有其中的一部分fd处于就绪状态,这个时候使用epoll能够明显提升性能

ET、LT、EPOLLONESHOT

  • LT水平触发模式

  • epoll_wait检测到文件描述符有事件发生,则将其通知给应用程序,应用程序可以不立即处理该事件。

  • 当下一次调用epoll_wait时,epoll_wait还会再次向应用程序报告此事件,直至被处理

  • ET边缘触发模式

  • epoll_wait检测到文件描述符有事件发生,则将其通知给应用程序,应用程序必须立即处理该事件

  • 必须要一次性将数据读取完,使用非阻塞I/O,读取到出现eagain

  • EPOLLONESHOT

  • 一个线程读取某个socket上的数据后开始处理数据,在处理过程中该socket上又有新数据可读,此时另一个线程被唤醒读取,此时出现两个线程处理同一个socket

  • 我们期望的是一个socket连接在任一时刻都只被一个线程处理,通过epoll_ctl对该文件描述符注册epolloneshot事件,一个线程处理socket时,其他线程将无法处理,当该线程处理完后,需要通过epoll_ctl重置epolloneshot事件

HTTP报文

HTTP报文分为请求报文和响应报文两种,每种报文必须按照特有格式生成,才能被浏览器端识别。
其中,浏览器端向服务器发送的为请求报文,服务器处理后返回给浏览器端的为响应报文。

请求报文

HTTP请求报文由请求行(request line)、请求头部(header)、空行和请求数据四个部分组成。
其中,请求分为两种,GET和POST,具体的:

  • GET
1    GET /562f25980001b1b106000338.jpg HTTP/1.1 
2    Host:img.mukewang.com
3    User-Agent:Mozilla/5.0 (Windows NT 10.0; WOW64) 4    AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.106 Safari/537.36 5    Accept:image/webp,image/*,*/*;q=0.8
6    Referer:http://www.imooc.com/
7    Accept-Encoding:gzip, deflate, sdch
8    Accept-Language:zh-CN,zh;q=0.8 9    空行10    请求数据为空
  • POST
    1    POST / HTTP1.1
    2    Host:www.wrox.com
    3    UserAgent:Mozilla/4.0 (compatible; MSIE 6.0; Windows NT 5.1; SV1; .NET CLR 2.0.50727; .NET CLR 3.0.04506.648; .NET CLR 3.5.21022)
    4    Content-Type:application/x-www-form-urlencoded
    5    Content-Length:40
    6    Connection: Keep-Alive
    7    空行
    8    name=Professional%20Ajax&publisher=Wiley

响应报文

HTTP响应也由四个部分组成,分别是:状态行、消息报头、空行和响应正文。

1 HTTP/1.1 200 OK 
2 Date: Fri, 22 May 2009 06:07:21 GMT
3 Content-Type: text/html; charset=UTF-8
4 空行
5<html>
6<head></head>
7      <body>
8            <!--body goes here-->
9      </body>
10</html>
  • 状态行,由HTTP协议版本号, 状态码, 状态消息 三部分组成。
    第一行为状态行,(HTTP/1.1)表明HTTP版本为1.1版本,状态码为200,状态消息为OK。

  • 消息报头,用来说明客户端要使用的一些附加信息。
    第二行和第三行为消息报头,Date:生成响应的日期和时间;Content-Type:指定了MIME类型的HTML(text/html),编码类型是UTF-8。

  • 空行,消息报头后面的空行是必须的。

  • 响应正文,服务器返回给客户端的文本信息。空行后面的html部分为响应正文。

响应状态码

HTTP有5种类型的状态码,具体的:

  • 1xx:指示信息–表示请求已接收,继续处理。

  • 2xx:成功–表示请求正常处理完毕。

  • 200 OK:客户端请求被正常处理。

  • 206 Partial content:客户端进行了范围请求。

  • 3xx:重定向–要完成请求必须进行更进一步的操作

  • 301 Moved Permanently:永久重定向,该资源已被永久移动到新位置,将来任何对该资源的访问都要使用本响应返回的若干个URI之一。

  • 302 Found:临时重定向,请求的资源现在临时从不同的URI中获得。

  • 4xx:客户端错误–请求有语法错误,服务器无法处理请求。

  • 400 Bad Request:请求报文存在语法错误。

  • 403 Forbidden:请求被服务器拒绝。

  • 404 Not Found:请求不存在,服务器上找不到请求的资源。

  • 5xx:服务器端错误–服务器处理请求出错。

  • 500 Internal Server Error:服务器在执行请求时出现错误。

HTTP请求解析

有限状态机,是一种抽象的理论模型,它能够把有限个变量描述的状态变化过程,以可构造可验证的方式呈现出来。比如,封闭的有向图。

有限状态机可以通过if-else,switch-case和函数指针来实现,从软件工程的角度看,主要是为了封装逻辑。

首先对http报文处理的流程进行简要介绍,然后具体介绍http类的定义和服务器接收http请求的具体过程。

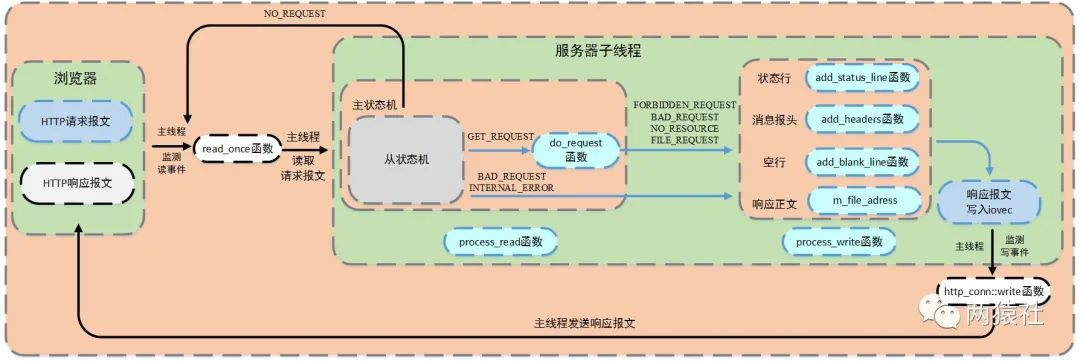
  • 浏览器端发出http连接请求,主线程创建http对象接收请求并将所有数据读入对应buffer,将该对象插入任务队列,工作线程从任务队列中取出一个任务进行处理。

    • 工作线程取出任务后,调用process_read函数,通过主、从状态机对请求报文进行解析。

    • 解析完之后,跳转do_request函数生成响应报文,通过process_write写入buffer,返回给浏览器端。

在HTTP报文中,每一行的数据由\r\n作为结束字符,空行则是仅仅是字符\r\n。因此,可以通过查找\r\n将报文拆解成单独的行进行解析,项目中便是利用了这一点。

从状态机负责读取buffer中的数据,将每行数据末尾的\r\n置为\0\0,并更新从状态机在buffer中读取的位置m_checked_idx,以此来驱动主状态机解析。

  • 从状态机从m_read_buf中逐字节读取,判断当前字节是否为\r

    • 接下来的字符是\n,将\r\n修改成\0\0,将m_checked_idx指向下一行的开头,则返回LINE_OK

    • 接下来达到了buffer末尾,表示buffer还需要继续接收,返回LINE_OPEN

    • 否则,表示语法错误,返回LINE_BAD

  • 当前字节不是\r,判断是否是\n(一般是上次读取到\r就到了buffer末尾,没有接收完整,再次接收时会出现这种情况)

    • 如果前一个字符是\r,则将\r\n修改成\0\0,将m_checked_idx指向下一行的开头,则返回LINE_OK
  • 当前字节既不是\r,也不是\n

    • 表示接收不完整,需要继续接收,返回LINE_OPEN

主从状态机

流程图和代码分别对状态机和服务器解析请求报文进行详解。
流程图部分,描述主、从状态机调用关系与状态转移过程。
代码部分,结合代码对http请求报文的解析进行详解。

  • 主状态机

三种状态,标识解析位置。

  • CHECK_STATE_REQUESTLINE,解析请求行

  • CHECK_STATE_HEADER,解析请求头

  • CHECK_STATE_CONTENT,解析消息体,仅用于解析POST请求

  • 从状态机

三种状态,标识解析一行的读取状态。

  • LINE_OK,完整读取一行

  • LINE_BAD,报文语法有误

  • LINE_OPEN,读取的行不完整

在http请求接收部分,会涉及到init和read_once函数,但init仅仅是对私有成员变量进行初始化,不用过多讲解。

这里,对read_once进行介绍。read_once读取浏览器端发送来的请求报文,直到无数据可读或对方关闭连接,读取到m_read_buffer中,并更新m_read_idx。

HTTP_CODE含义

表示HTTP请求的处理结果,在头文件中初始化了八种情形,在报文解析时只涉及到四种。

  • NO_REQUEST: 请求不完整,需要继续读取请求报文数据

  • GET_REQUEST: 获得了完整的HTTP请求

  • BAD_REQUEST: HTTP请求报文有语法错误

  • INTERNAL_ERROR: 服务器内部错误,该结果在主状态机逻辑switch的default下,一般不会触发

解析报文整体流程

process_read通过while循环,将主从状态机进行封装,对报文的每一行进行循环处理。

循环条件
while((m_check_state==CHECK_STATE_CONTENT && line_status==LINE_OK)||((line_status=parse_line())==LINE_OK))

在GET请求报文中,每一行都是\r\n作为结束,所以对报文进行拆解时,仅用从状态机的状态line_status=parse_line())==LINE_OK语句即可。

但,在POST请求报文中,消息体的末尾没有任何字符,所以不能使用从状态机的状态,这里转而使用主状态机的状态作为循环入口条件。

  • 判断条件

    • 主状态机转移到CHECK_STATE_CONTENT,该条件涉及解析消息体

    • 从状态机转移到LINE_OK,该条件涉及解析请求行和请求头部

    • 两者为或关系,当条件为真则继续循环,否则退出

  • 循环体

    • 从状态机读取数据

    • 调用get_line函数,通过m_start_line将从状态机读取数据间接赋给text

    • 主状态机解析text

解析完消息体后,报文的完整解析就完成了,但此时主状态机的状态还是CHECK_STATE_CONTENT,也就是说,符合循环入口条件,还会再次进入循环,这并不是我们所希望的。

为此,增加了该语句,并在完成消息体解析后,将line_status变量更改为LINE_OPEN,此时可以跳出循环,完成报文解析任务。

CHECK_STATE_REQUESTLINE

主状态机初始状态是CHECK_STATE_REQUESTLINE,通过调用从状态机来驱动主状态机,在主状态机进行解析前,从状态机已经将每一行的末尾\r\n符号改为\0\0,以便于主状态机直接取出对应字符串进行处理。

  • CHECK_STATE_REQUESTLINE

    • 主状态机的初始状态,调用parse_request_line函数解析请求行
    • 解析函数从m_read_buf中解析HTTP请求行,获得请求方法、目标URL及HTTP版本号
    • 解析完成后主状态机的状态变为CHECK_STATE_HEADER

解析完请求行后,主状态机继续分析请求头。在报文中,请求头和空行的处理使用的同一个函数,这里通过判断当前的text首位是不是\0字符,若是,则表示当前处理的是空行,若不是,则表示当前处理的是请求头。

CHECK_STATE_HEADER
  • CHECK_STATE_HEADER

    • 调用parse_headers函数解析请求头部信息

    • 判断是空行还是请求头,若是空行,进而判断content-length是否为0,如果不是0,表明是POST请求,则状态转移到CHECK_STATE_CONTENT,否则说明是GET请求,则报文解析结束。

    • 若解析的是请求头部字段,则主要分析connection字段,content-length字段,其他字段可以直接跳过,各位也可以根据需求继续分析。

    • 若解析的是请求头部字段,则主要分析connection字段,content-length字段,其他字段可以直接跳过,各位也可以根据需求继续分析。 connection字段判断是keep-alive还是close,决定是长连接还是短连接

    • content-length字段,这里用于读取post请求的消息体长度

如果仅仅是GET请求,如项目中的欢迎界面,那么主状态机只设置之前的两个状态足矣。

因为在上篇推文中我们曾说道,GET和POST请求报文的区别之一是有无消息体部分,GET请求没有消息体,当解析完空行之后,便完成了报文的解析。

但后续的登录和注册功能,为了避免将用户名和密码直接暴露在URL中,我们在项目中改用了POST请求,将用户名和密码添加在报文中作为消息体进行了封装。

为此,我们需要在解析报文的部分添加解析消息体的模块。

CHECK_STATE_CONTENT
  • 仅用于解析POST请求,调用parse_content函数解析消息体

  • 用于保存post请求消息体,为后面的登录和注册做准备

HTTP响应处理

基础知识:

介绍stat、mmap、iovec、writev

stat

stat函数用于取得指定文件的文件属性,并将文件属性存储在结构体stat里,这里仅对其中用到的成员进行介绍。

#include <sys/stat.h>

//获取文件属性,存储在statbuf中
int stat(const char *pathname, struct stat *statbuf);

//完整定义很长, 仅介绍用到的
struct stat 
{
   mode_t    st_mode;        /* 文件类型和权限 */
   off_t     st_size;        /* 文件大小,字节数*/
};

stat(m_real_file, &m_file_stat)<0

mmap

用于将一个文件或其他对象映射到内存,提高文件的访问速度。

void* mmap(void* start,size_t length,int prot,int flags,int fd,off_t offset);
int munmap(void* start,size_t length);
  • start:映射区的开始地址,设置为0时表示由系统决定映射区的起始地址

  • length:映射区的长度

  • prot:期望的内存保护标志,不能与文件的打开模式冲突

    • PROT_READ 表示页内容可以被读取
  • flags:指定映射对象的类型,映射选项和映射页是否可以共享

    • MAP_PRIVATE 建立一个写入时拷贝的私有映射,内存区域的写入不会影响到原文件
  • fd:有效的文件描述符,一般是由open()函数返回

  • off_toffset:被映射对象内容的起点

iovec

定义了一个向量元素,通常,这个结构用作一个多元素的数组。

struct iovec
{
void *iov_base; /* Pointer to data. */
size_t iov_len; /* Length of data. */
};

  • iov_base指向数据的地址
  • iov_len表示数据的长度
writenv

writev函数用于在一次函数调用中写多个非连续缓冲区,有时也将这该函数称为聚集写。

#include <sys/uio.h>
ssize_t writev(int filedes, const struct iovec *iov, int iovcnt);
  • filedes表示文件描述符

  • iov为前述io向量机制结构体iovec

  • iovcnt为结构体的个数

若成功则返回已写的字节数,若出错则返回-1。writev以顺序iov[0],iov[1]至iov[iovcnt-1]从缓冲区中聚集输出数据。writev返回输出的字节总数,通常,它应等于所有缓冲区长度之和。

特别注意: 循环调用writev时,需要重新处理iovec中的指针和长度,该函数不会对这两个成员做任何处理。writev的返回值为已写的字节数,但这个返回值“实用性”并不高,因为参数传入的是iovec数组,计量单位是iovcnt,而不是字节数,我们仍然需要通过遍历iovec来计算新的基址,另外写入数据的“结束点”可能位于一个iovec的中间某个位置,因此需要调整临界iovec的io_base和io_len。

do_request()

浏览器端发出HTTP请求报文,服务器端接收该报文并调用process_read对其进行解析,根据解析结果HTTP_CODE,进入相应的逻辑和模块。

其中,服务器子线程完成报文的解析与响应;主线程监测读写事件,调用read_once和http_conn::write完成数据的读取与发送。

process_read函数的返回值是对请求的文件分析后的结果,一部分是语法错误导致的BAD_REQUEST,一部分是do_request的返回结果.该函数将网站根目录和url文件拼接,然后通过stat判断该文件属性。另外,为了提高访问速度,通过mmap进行映射,将普通文件映射到内存逻辑地址。

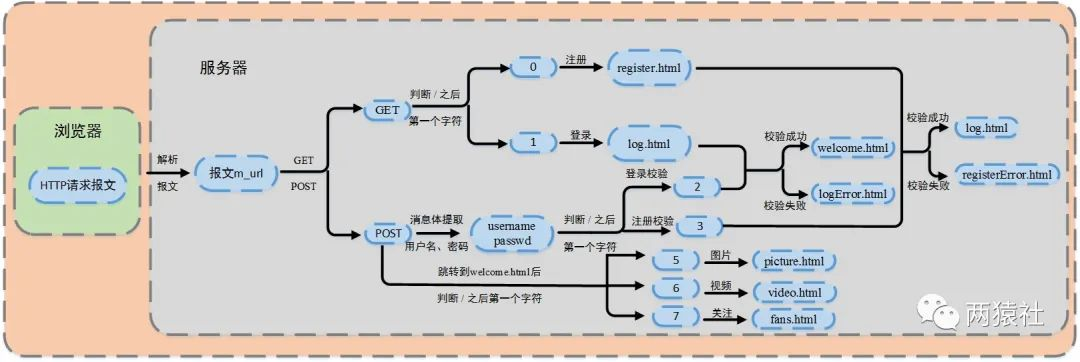
为了更好的理解请求资源的访问流程,这里对各种各页面跳转机制进行简要介绍。其中,浏览器网址栏中的字符,即url,可以将其抽象成ip:port/xxx,xxx通过html文件的action属性进行设置。

m_url为请求报文中解析出的请求资源,以/开头,也就是/xxx,项目中解析后的m_url有8种情况。

m_url为请求报文中解析出的请求资源,以/开头,也就是/xxx,项目中解析后的m_url有8种情况。

  • /

  • GET请求,跳转到judge.html,即欢迎访问页面

  • /0

  • POST请求,跳转到register.html,即注册页面

  • /1

  • POST请求,跳转到log.html,即登录页面

  • /2CGISQL.cgi

  • POST请求,进行登录校验

  • 验证成功跳转到welcome.html,即资源请求成功页面

  • 验证失败跳转到logError.html,即登录失败页面

  • /3CGISQL.cgi

  • POST请求,进行注册校验

  • 注册成功跳转到log.html,即登录页面

  • 注册失败跳转到registerError.html,即注册失败页面

  • /5

  • POST请求,跳转到picture.html,即图片请求页面

  • /6

  • POST请求,跳转到video.html,即视频请求页面

  • /7

  • POST请求,跳转到fans.html,即关注页面

process_write()

根据do_request的返回状态,服务器子线程调用process_write向m_write_buf中写入响应报文。

  • add_status_line函数,添加状态行:http/1.1 状态码 状态消息

  • add_headers函数添加消息报头,内部调用add_content_length和add_linger函数

  • content-length记录响应报文长度,用于浏览器端判断服务器是否发送完数据

  • connection记录连接状态,用于告诉浏览器端保持长连接

  • add_blank_line添加空行

上述涉及的5个函数,均是内部调用add_response函数更新m_write_idx指针和缓冲区m_write_buf中的内容。

响应报文分为两种,一种是请求文件的存在,通过io向量机制iovec,声明两个iovec,第一个指向m_write_buf,第二个指向mmap的地址m_file_address;一种是请求出错,这时候只申请一个iovec,指向m_write_buf。

  • iovec是一个结构体,里面有两个元素,指针成员iov_base指向一个缓冲区,这个缓冲区是存放的是writev将要发送的数据。

  • 成员iov_len表示实际写入的长度

http_conn::write()

服务器子线程调用process_write完成响应报文,随后注册epollout事件。服务器主线程检测写事件,并调用http_conn::write函数将响应报文发送给浏览器端。

该函数具体逻辑如下:

在生成响应报文时初始化byte_to_send,包括头部信息和文件数据大小。通过writev函数循环发送响应报文数据,根据返回值更新byte_have_send和iovec结构体的指针和长度,并判断响应报文整体是否发送成功。

  • 若writev单次发送成功,更新byte_to_send和byte_have_send的大小,若响应报文整体发送成功,则取消mmap映射,并判断是否是长连接.

    • 长连接重置http类实例,注册读事件,不关闭连接,

    • 短连接直接关闭连接

  • 若writev单次发送不成功,判断是否是写缓冲区满了。

    • 若不是因为缓冲区满了而失败,取消mmap映射,关闭连接

    • 若eagain则满了,更新iovec结构体的指针和长度,并注册写事件,等待下一次写事件触发(当写缓冲区从不可写变为可写,触发epollout),因此在此期间无法立即接收到同一用户的下一请求,但可以保证连接的完整性。

05定时器处理非活动连接

由于非活跃连接占用了连接资源,严重影响服务器的性能,通过实现一个服务器定时器,处理这种非活跃连接,释放连接资源。利用alarm函数周期性地触发SIGALRM信号,该信号的信号处理函数利用管道通知主循环执行定时器链表上的定时任务.

  • 统一事件源
  • 基于升序链表的定时器
  • 处理非活动连接

非活跃,是指客户端(这里是浏览器)与服务器端建立连接后,长时间不交换数据,一直占用服务器端的文件描述符,导致连接资源的浪费。

定时事件,是指固定一段时间之后触发某段代码,由该段代码处理一个事件,如从内核事件表删除事件,并关闭文件描述符,释放连接资源。

定时器,是指利用结构体或其他形式,将多种定时事件进行封装起来。具体的,这里只涉及一种定时事件,即定期检测非活跃连接,这里将该定时事件与连接资源封装为一个结构体定时器。

定时器容器,是指使用某种容器类数据结构,将上述多个定时器组合起来,便于对定时事件统一管理。具体的,项目中使用升序链表将所有定时器串联组织起来。

本项目中,服务器主循环为每一个连接创建一个定时器,并对每个连接进行定时。另外,利用升序时间链表容器将所有定时器串联起来,若主循环接收到定时通知,则在链表中依次执行定时任务。

Linux下提供了三种定时的方法:

  • socket选项SO_RECVTIMEO和SO_SNDTIMEO

  • SIGALRM信号

  • I/O复用系统调用的超时参数

三种方法没有一劳永逸的应用场景,也没有绝对的优劣。由于项目中使用的是SIGALRM信号,这里仅对其进行介绍,另外两种方法可以查阅游双的Linux高性能服务器编程 第11章 定时器。

具体的,利用alarm函数周期性地触发SIGALRM信号,信号处理函数利用管道通知主循环,主循环接收到该信号后对升序链表上所有定时器进行处理,若该段时间内没有交换数据,则将该连接关闭,释放所占用的资源。

从上面的简要描述中,可以看出定时器处理非活动连接模块,主要分为两部分,其一为定时方法与信号通知流程,其二为定时器及其容器设计与定时任务的处理。

基础API,描述sigaction结构体、sigaction函数、sigfillset函数、SIGALRM信号、SIGTERM信号、alarm函数、socketpair函数、send函数。

信号通知流程,介绍统一事件源和信号处理机制。

代码实现,结合代码对信号处理函数的设计与使用进行详解。

信号通知流程

Linux下的信号采用的异步处理机制,信号处理函数和当前进程是两条不同的执行路线。具体的,当进程收到信号时,操作系统会中断进程当前的正常流程,转而进入信号处理函数执行操作,完成后再返回中断的地方继续执行。

为避免信号竞态现象发生,信号处理期间系统不会再次触发它。所以,为确保该信号不被屏蔽太久,信号处理函数需要尽可能快地执行完毕。

一般的信号处理函数需要处理该信号对应的逻辑,当该逻辑比较复杂时,信号处理函数执行时间过长,会导致信号屏蔽太久。

这里的解决方案是,信号处理函数仅仅发送信号通知程序主循环,将信号对应的处理逻辑放在程序主循环中,由主循环执行信号对应的逻辑代码。

统一事件源

统一事件源,是指将信号事件与其他事件一样被处理。

具体的,信号处理函数使用管道将信号传递给主循环,信号处理函数往管道的写端写入信号值,主循环则从管道的读端读出信号值,使用I/O复用系统调用来监听管道读端的可读事件,这样信号事件与其他文件描述符都可以通过epoll来监测,从而实现统一处理。

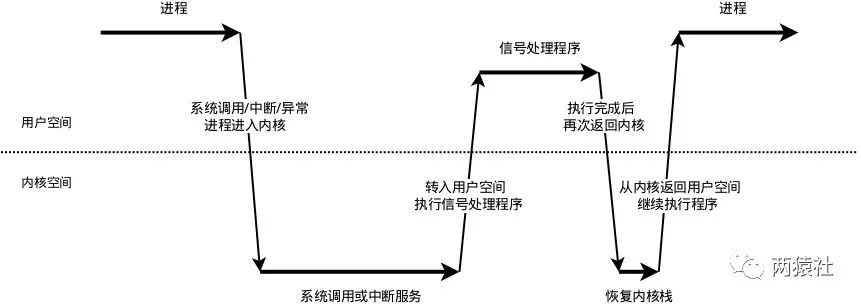
信号处理机制

每个进程之中,都有存着一个表,里面存着每种信号所代表的含义,内核通过设置表项中每一个位来标识对应的信号类型。

  • 信号的接收

  • 接收信号的任务是由内核代理的,当内核接收到信号后,会将其放到对应进程的信号队列中,同时向进程发送一个中断,使其陷入内核态。注意,此时信号还只是在队列中,对进程来说暂时是不知道有信号到来的。

  • 信号的检测

  • 进程从内核态返回到用户态前进行信号检测

  • 进程在内核态中,从睡眠状态被唤醒的时候进行信号检测

  • 进程陷入内核态后,有两种场景会对信号进行检测:

  • 当发现有新信号时,便会进入下一步,信号的处理。

  • 信号的处理

  • ( 内核 )信号处理函数是运行在用户态的,调用处理函数前,内核会将当前内核栈的内容备份拷贝到用户栈上,并且修改指令寄存器(eip)将其指向信号处理函数。

  • ( 用户 )接下来进程返回到用户态中,执行相应的信号处理函数。

  • ( 内核 )信号处理函数执行完成后,还需要返回内核态,检查是否还有其它信号未处理。

  • ( 用户 )如果所有信号都处理完成,就会将内核栈恢复(从用户栈的备份拷贝回来),同时恢复指令寄存器(eip)将其指向中断前的运行位置,最后回到用户态继续执行进程。

至此,一个完整的信号处理流程便结束了,如果同时有多个信号到达,上面的处理流程会在第2步和第3步骤间重复进行。

定时器容器

项目中的定时器容器为带头尾结点的升序双向链表,具体的为每个连接创建一个定时器,将其添加到链表中,并按照超时时间升序排列。执行定时任务时,将到期的定时器从链表中删除。

从实现上看,主要涉及双向链表的插入,删除操作,其中添加定时器的事件复杂度是O(n),删除定时器的事件复杂度是O(1)。

升序双向链表主要逻辑如下,具体的,

  • 创建头尾节点,其中头尾节点没有意义,仅仅统一方便调整

  • add_timer函数,将目标定时器添加到链表中,添加时按照升序添加

  • 若当前链表中只有头尾节点,直接插入

  • 否则,将定时器按升序插入

  • adjust_timer函数,当定时任务发生变化,调整对应定时器在链表中的位置

  • 客户端在设定时间内有数据收发,则当前时刻对该定时器重新设定时间,这里只是往后延长超时时间

  • 被调整的目标定时器在尾部,或定时器新的超时值仍然小于下一个定时器的超时,不用调整

  • 否则先将定时器从链表取出,重新插入链表

  • del_timer函数将超时的定时器从链表中删除

  • 常规双向链表删除结点

06日志系统

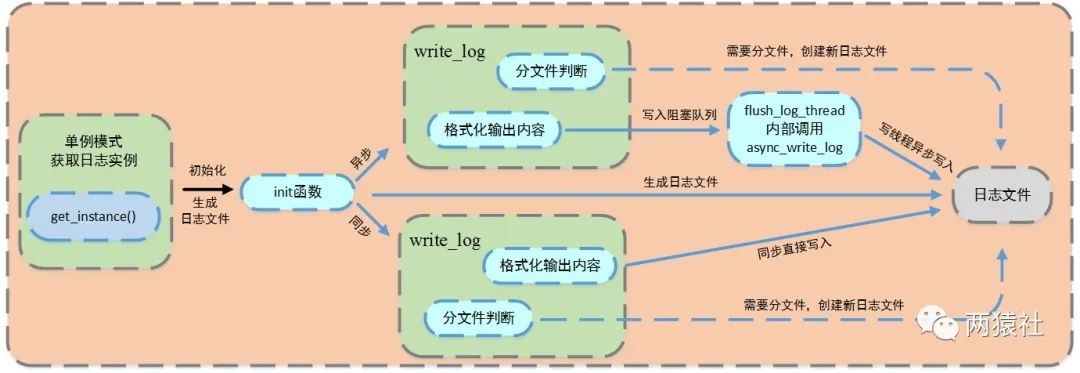
同步/异步日志系统主要涉及了两个模块,一个是日志模块,一个是阻塞队列模块,其中加入阻塞队列模块主要是解决异步写入日志做准备.

  • 自定义阻塞队列
  • 单例模式创建日志
  • 同步日志
  • 异步日志
  • 实现按天、超行分类

日志,由服务器自动创建,并记录运行状态,错误信息,访问数据的文件。

同步日志,日志写入函数与工作线程串行执行,由于涉及到I/O操作,当单条日志比较大的时候,同步模式会阻塞整个处理流程,服务器所能处理的并发能力将有所下降,尤其是在峰值的时候,写日志可能成为系统的瓶颈。

生产者-消费者模型,并发编程中的经典模型。以多线程为例,为了实现线程间数据同步,生产者线程与消费者线程共享一个缓冲区,其中生产者线程往缓冲区中push消息,消费者线程从缓冲区中pop消息。

阻塞队列,将生产者-消费者模型进行封装,使用循环数组实现队列,作为两者共享的缓冲区。

异步日志,将所写的日志内容先存入阻塞队列,写线程从阻塞队列中取出内容,写入日志。

单例模式,最简单也是被问到最多的设计模式之一,保证一个类只创建一个实例,同时提供全局访问的方法。

本项目中,使用单例模式创建日志系统,对服务器运行状态、错误信息和访问数据进行记录,该系统可以实现按天分类,超行分类功能,可以根据实际情况分别使用同步和异步写入两种方式。

其中异步写入方式,将生产者-消费者模型封装为阻塞队列,创建一个写线程,工作线程将要写的内容push进队列,写线程从队列中取出内容,写入日志文件。

日志系统大致可以分成两部分,其一是单例模式与阻塞队列的定义,其二是日志类的定义与使用。

单例模式,描述懒汉与饿汉两种单例模式,并结合线程安全进行讨论。

生产者-消费者模型,描述条件变量,基于该同步机制实现简单的生产者-消费者模型。

代码实现,结合代码对阻塞队列的设计进行详解。

单例模式

单例模式作为最常用的设计模式之一,保证一个类仅有一个实例,并提供一个访问它的全局访问点,该实例被所有程序模块共享。

实现思路:私有化它的构造函数,以防止外界创建单例类的对象;使用类的私有静态指针变量指向类的唯一实例,并用一个公有的静态方法获取该实例。

单例模式有两种实现方法,分别是懒汉和饿汉模式。顾名思义,懒汉模式,即非常懒,不用的时候不去初始化,所以在第一次被使用时才进行初始化;饿汉模式,即迫不及待,在程序运行时立即初始化。

阻塞队列

阻塞队列是一种特殊的队列数据结构,它具有阻塞功能。当队列为空时,从队列中取元素的操作会被阻塞,直到队列中有新的元素被加入;同样地,当队列已满时,向队列中添加元素的操作也会被阻塞,直到队列中有空闲位置。

通过阻塞队列,我们可以很方便地实现线程间的协作和同步。比如,一个线程可以往阻塞队列中添加任务,另一个线程可以从队列中取出任务并执行。如果队列为空,取任务的线程就会被阻塞,直到有新的任务被添加到队列中;如果队列已满,添加任务的线程就会被阻塞,直到队列中有空闲位置。

07WebServer

总流程

流程图,描述服务器从报文中提取出用户名密码,并完成注册和登录校验后,实现页面跳转的逻辑。

载入数据库表,结合代码将数据库中的数据载入到服务器中。

提取用户名和密码,结合代码对报文进行解析,提取用户名和密码。

注册登录流程,结合代码对描述服务器进行注册和登录校验的流程。

页面跳转,结合代码对页面跳转机制进行详解。