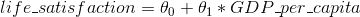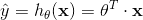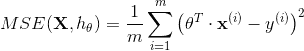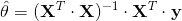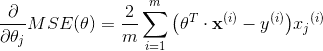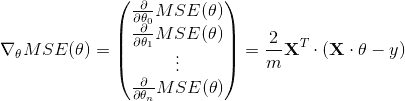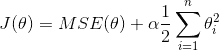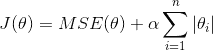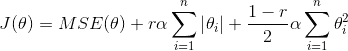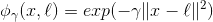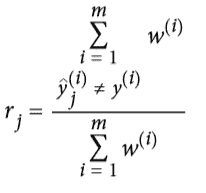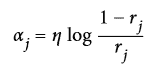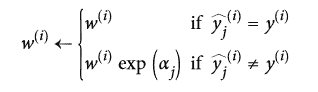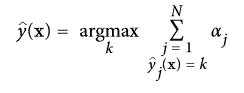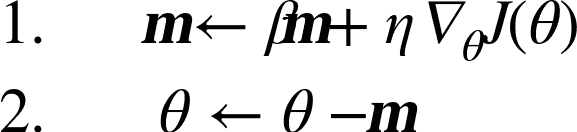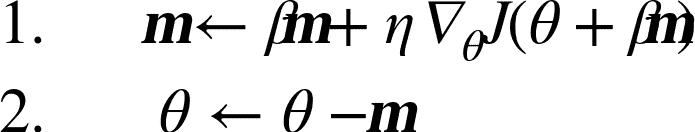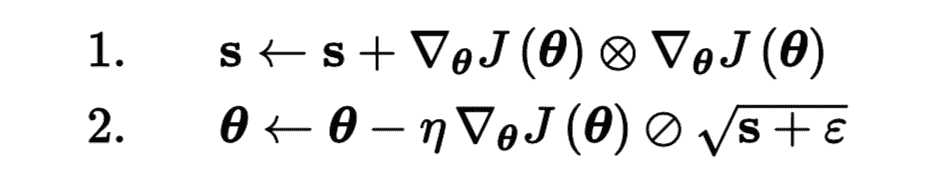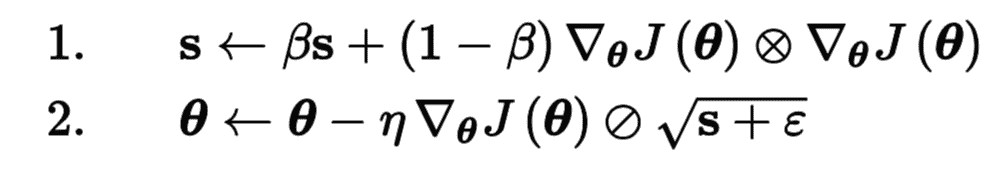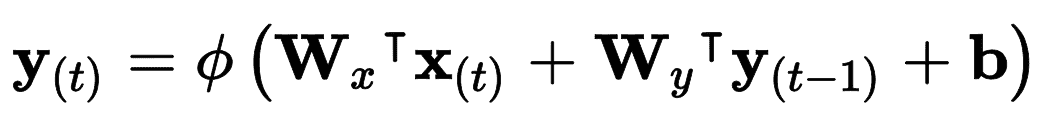人工智能笔记 机器学习概览 总结一下, 机器学习善于:
需要进行大量手工调整或需要拥有长串规则才能解决的问题: 机器学习算法通常可以简化代码、 提高性能。
问题复杂, 传统方法难以解决: 最好的机器学习方法可以找到解决方案。
环境有波动: 机器学习算法可以适应新数据
洞察复杂问题和大量数据。
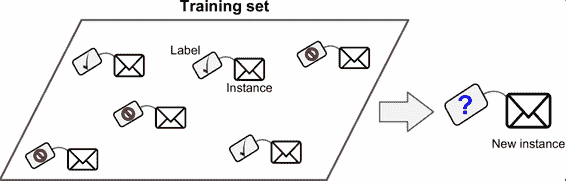
监督学习和非监督学习 在监督学习中, 用来训练算法的训练数据包含了答案, 称为标签( 图 1-5) 。
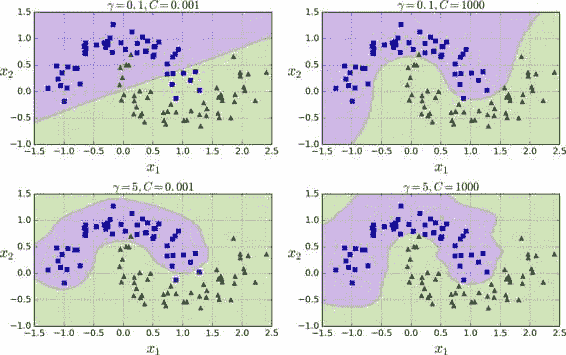
图 1-5 用于监督学习( 比如垃圾邮件分类) 的加了标签的训练集
一个典型的监督学习任务是分类。 垃圾邮件过滤器就是一个很好的例子: 用许多带有归类( 垃圾邮件或普通邮件) 的邮件样本进行训练, 过滤器必须还能对新邮件进行分类。
另一个典型任务是预测目标数值, 例如给出一些特征( 里程数、 车龄、 品牌等等) 称作预测值, 来预测一辆汽车的价格。 这类任务称作回归( 图 1-6) 。 要训练这个系统, 你需要给出大量汽车样本, 包括它们的预测值和标签( 即, 它们的价格) 。
下面是一些重要的监督学习算法( 本书都有介绍) :
K 近邻算法
线性回归
逻辑回归
支持向量机( SVM)
决策树和随机森林
神经网络
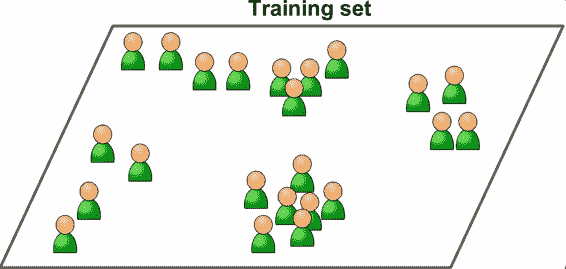
在非监督学习中, 你可能猜到了, 训练数据是没有加标签的( 图 1-7) 。 系统在没有老师的条件下进行学习。
下面是一些最重要的非监督学习算法( 我们会在第 8 章介绍降维) :
聚类 K 均值 层次聚类分析( Hierarchical Cluster Analysis, HCA) 期望最大值
可视化和降维 主成分分析( Principal Component Analysis, PCA) 核主成分分析 局部线性嵌入( Locally-Linear Embedding, LLE) t-分布邻域嵌入算法( t-distributed Stochastic Neighbor Embedding, t-SNE)
关联性规则学习 Apriori 算法 Eclat 算法
一些算法可以处理部分带标签的训练数据, 通常是大量不带标签数据加上小部分带标签数据。 这称作半监督学习 ( 图 1-11) 。
一些图片存储服务, 比如 Google Photos, 是半监督学习的好例子。 一旦你上传了所有家庭相片, 它就能自动识别到人物 A 出现在了相片 1、 5、 11 中, 另一个人 B 出现在了相片 2、 5、 7 中。 这是算法的非监督部分( 聚类) 。 现在系统需要的就是你告诉它这两个人是谁。 只要给每个人一个标签, 算法就可以命名每张照片中的每个人, 特别适合搜索照片。
强化学习 强化学习非常不同。 学习系统在这里被称为智能体( agent) , 可以对环境进行观察、 选择和执行动作, 并获得奖励作为回报( 负奖励是惩罚, 见图 1-12) 。 然后它必须自己学习哪个是最佳方法( 称为策略, policy) , 以得到长久的最大奖励。 策略决定了智能体在给定情况下应该采取的行动。
批量和在线学习 批量学习 在批量学习中, 系统不能进行持续学习: 必须用所有可用数据进行训练。 这通常会占用大量时间和计算资源, 所以一般是线下做的。 首先是进行训练, 然后部署在生产环境且停止学习, 它只是使用已经学到的策略。 这称为离线学习。
如果你想让一个批量学习系统明白新数据( 例如垃圾邮件的新类型) , 就需要从头训练一个系统的新版本, 使用全部数据集( 不仅有新数据也有老数据) , 然后停掉老系统, 换上新系统。
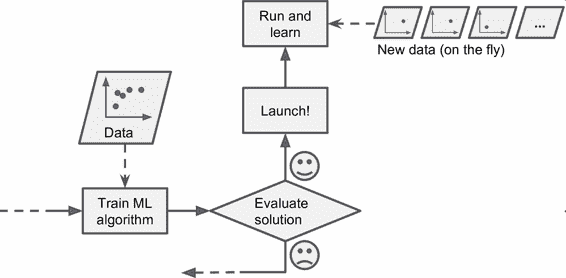
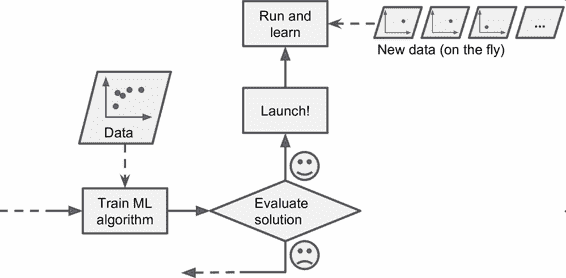
幸运的是, 训练、 评估、 部署一套机器学习的系统的整个过程可以自动进行( 见图 1-3) , 所以即便是批量学习也可以适应改变。 只要有需要, 就可以方便地更新数据、 训练一个新版本。
这个方法很简单, 通常可以满足需求, 但是用全部数据集进行训练会花费大量时间, 所以一般是每 24 小时或每周训练一个新系统。 如果系统需要快速适应变化的数据( 比如, 预测股价变化) , 就需要一个响应更及时的方案。
在线学习 在在线学习中, 是用数据实例持续地进行训练, 可以一次一个或一次几个实例( 称为小批量) 。 每个学习步骤都很快且廉价, 所以系统可以动态地学习收到的最新数据( 见图 1-13) 。
图 1-13 在线学习
在线学习很适合系统接收连续流的数据( 比如, 股票价格) , 且需要自动对改变作出调整。 如果计算资源有限, 在线学习是一个不错的方案: 一旦在线学习系统学习了新的数据实例, 它就不再需要这些数据了, 所以扔掉这些数据( 除非你想滚回到之前的一个状态, 再次使用数据) 。 这样可以节省大量的空间。
在线学习算法也适用于在超大数据集( 一台计算机不足以用于存储它) 上训练系统( 这称作核外学习, out-of-core learning) 。 算法每次只加载部分数据, 用这些数据进行训练, 然后重复这个过程, 直到使用完所有数据( 见图 1-14) 。
警告: 这个整个过程通常是离线完成的( 即, 不在部署的系统上) , 所以在线学习这个名字会让人疑惑。 可以把它想成持续学习。
图 1-14 使用在线学习处理大量数据集
在线学习系统的一个重要参数是, 它们可以多快地适应数据的改变: 这被称为学习速率。 如果你设定一个高学习速率, 系统就可以快速适应新数据, 但是也会快速忘记老数据( 你可不想让垃圾邮件过滤器只标记最新的垃圾邮件种类) 。 相反的, 如果你设定的学习速率低, 系统的惰性就会强: 即, 它学的更慢, 但对新数据中的噪声或没有代表性的数据点结果不那么敏感。
在线学习的挑战之一是, 如果坏数据被用来进行训练, 系统的性能就会逐渐下滑。 如果这是一个部署的系统, 用户就会注意到。 例如, 坏数据可能来自失灵的传感器或机器人, 或某人向搜索引擎传入垃圾信息以提高搜索排名。 要减小这种风险, 你需要密集监测, 如果检测到性能下降, 要快速关闭( 或是滚回到一个之前的状态) 。 你可能还要监测输入数据, 对反常数据做出反应( 比如, 使用异常检测算法) 。
线性回归 在第一章, 我们介绍了一个简单的生活满意度回归模型:
这个模型仅仅是输入量GDP_per_capita的线性函数, θ[0]和θ[1]是这个模型的参数, 线性模型更一般化的描述指通过计算输入变量的加权和, 并加上一个常数偏置项( 截距项) 来得到一个预测值。 如公式 4-1:
公式 4-1: 线性回归预测模型
上述公式可以写成更为简洁的向量形式, 如公式 4-2:
公式 4-2: 线性回归预测模型( 向量形式)
怎么样去训练一个线性回归模型呢? 好吧, 回想一下, 训练一个模型指的是设置模型的参数使得这个模型在训练集的表现较好。
为此, 我们首先需要找到一个衡量模型好坏的评定方法。 在第二章, 我们介绍到在回归模型上, 最常见的评定标准是均方根误差( RMSE, 详见公式 2-1) 。 因此, 为了训练一个线性回归模型, 你需要找到一个θ值, 它使得均方根误差( 标准误差) 达到最小值。
实践过程中, 最小化均方误差比最小化均方根误差更加的简单, 这两个过程会得到相同的θ, 因为函数在最小值时候的自变量, 同样能使函数的方根运算得到最小值。
在训练集X上使用公式 4-3 来计算线性回归假设h[θ]的均方差( MSE) 。
公式 4-3: 线性回归模型的 MSE 损失函数
公式中符号的含义大多数都在第二章( 详见“ 符号” ) 进行了说明, 不同的是: 为了突出模型的参数向量θ, 使用h[θ]来代替h。 以后的使用中为了公式的简洁, 使用MSE(θ)来代替MSE(X, h[θ])。
正规方程求解MSE 为了找到最小化损失函数的θ值, 可以采用公式解, 换句话说, 就是可以通过解正规方程直接得到最后的结果。
公式 4-4: 正规方程
θ_hat指最小化损失θ的值
y是一个向量, 其包含了y^(1)到y^(m)的值
正规方程求解的方法问题在于:
正规方程需要计算矩阵X^T · X的逆, 它是一个n * n的矩阵( n是特征的个数) 。 这样一个矩阵求逆的运算复杂度大约在O(n^2.4)到O(n^3)之间, 具体值取决于计算方式。 换句话说, 如果你将你的特征个数翻倍的话, 其计算时间大概会变为原来的 5.3( 2^2.4) 到 8( 2^3) 倍。
提示
当特征的个数较大的时候( 例如: 特征数量为 100000) , 正规方程求解将会非常慢。
有利的一面是, 这个方程在训练集上对于每一个实例来说是线性的, 其复杂度为O(m), 因此只要有能放得下它的内存空间, 它就可以对大规模数据进行训练。 同时, 一旦你得到了线性回归模型( 通过解正规方程或者其他的算法) , 进行预测是非常快的。 因为模型中计算复杂度对于要进行预测的实例数量和特征个数都是线性的。 换句话说, 当实例个数变为原来的两倍多的时候( 或特征个数变为原来的两倍多) , 预测时间也仅仅是原来的两倍多。
如何训练模型?梯度下降 梯度下降是一种非常通用的优化算法, 它能够很好地解决一系列问题。 梯度下降的整体思路是通过的迭代来逐渐调整参数使得损失函数达到最小值。
假设浓雾下, 你迷失在了大山中, 你只能感受到自己脚下的坡度。 为了最快到达山底, 一个最好的方法就是沿着坡度最陡的地方下山。 这其实就是梯度下降所做的: 它计算误差函数关于参数向量Θ的局部梯度, 同时它沿着梯度下降的方向进行下一次迭代。 当梯度值为零的时候, 就达到了误差函数最小值 。
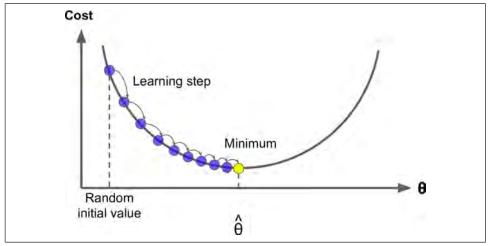
具体来说, 开始时, 需要选定一个随机的Θ( 这个值称为随机初始值) , 然后逐渐去改进它, 每一次变化一小步, 每一步都试着降低损失函数( 例如: 均方差损失函数) , 直到算法收敛到一个最小值( 如图: 4-3) 。
学习率learning rate
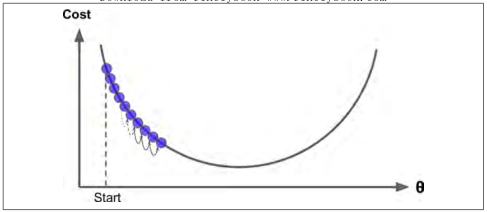
在梯度下降中一个重要的参数是步长, 超参数学习率的值决定了步长的大小。 如果学习率太小, 必须经过多次迭代, 算法才能收敛, 这是非常耗时的( 如图4-4) 。
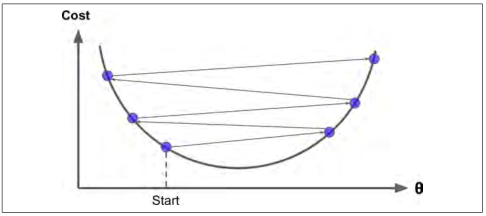
另一方面, 如果学习率太大, 你将跳过最低点, 到达山谷的另一面, 可能下一次的值比上一次还要大。 这可能使的算法是发散的, 函数值变得越来越大, 永远不可能找到一个好的答案( 如图4-5) 。
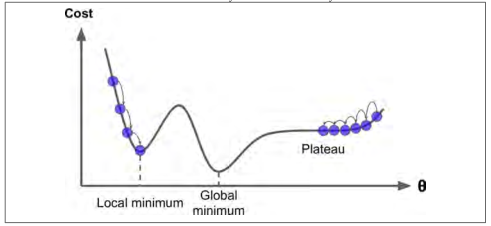
最后, 并不是所有的损失函数看起来都像一个规则的碗。 它们可能是洞, 山脊, 高原和各种不规则的地形, 使它们收敛到最小值非常的困难。 图4-6 显示了梯度下降的两个主要挑战: 如果随机初始值选在了图像的左侧, 则它将收敛到局部最小值, 这个值要比全局最小值要大。 如果它从右侧开始, 那么跨越高原将需要很长时间, 如果你早早地结束训练, 你将永远到不了全局最小值。
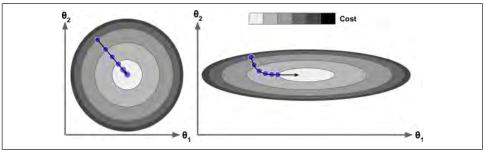
事实上, 损失函数的图像呈现碗状, 但是不同特征的取值范围相差较大的时, 这个碗可能是细长的。 图4-7 展示了梯度下降在不同训练集上的表现。 在左图中, 特征 1 和特征 2 有着相同的数值尺度。 在右图中, 特征 1 比特征 2 的取值要小的多, 由于特征 1 较小, 因此损失函数改变时, Θ[1]会有较大的变化, 于是这个图像会在Θ[1]轴方向变得细长。
当我们使用梯度下降的时候, 应该确保所有的特征有着相近的尺度范围( 例如: 使用 Scikit Learn 的 StandardScaler类) , 否则它将需要很长的时间才能够收敛。
批量梯度下降 使用梯度下降的过程中, 你需要计算每一个Θ[j]下损失函数的梯度。 换句话说, 你需要计算当Θ[j]变化一点点时, 损失函数改变了多少。 这称为偏导数, 它就像当你面对东方的时候问: “我脚下的坡度是多少? “。 然后面向北方的时候问同样的问题( 如果你能想象一个超过三维的宇宙, 可以对所有的方向都这样做) 。 公式 4-5 计算关于Θ[j]的损失函数的偏导数, 记为: ∂MSE/∂θ[j]。
为了避免单独计算每一个梯度, 你也可以使用公式 4-6 来一起计算它们。 梯度向量记为ᐁ[θ]MSE(θ), 其包含了损失函数所有的偏导数( 每个模型参数只出现一次) 。
随机梯度下降 批量梯度下降的最要问题是计算每一步的梯度时都需要使用整个训练集, 这导致在规模较大的数据集上, 其会变得非常的慢。 与其完全相反的随机梯度下降, 在每一步的梯度计算上只随机选取训练集中的一个样本。 很明显, 由于每一次的操作都使用了非常少的数据, 这样使得算法变得非常快。 由于每一次迭代, 只需要在内存中有一个实例, 这使随机梯度算法可以在大规模训练集上使用。
虽然随机性可以很好的跳过局部最优值, 但同时它却不能达到最小值。 解决这个难题的一个办法是逐渐降低学习率。 开始时, 走的每一步较大( 这有助于快速前进同时跳过局部最小值) , 然后变得越来越小, 从而使算法到达全局最小值。 这个过程被称为模拟退火, 因为它类似于熔融金属慢慢冷却的冶金学退火过程。 决定每次迭代的学习率的函数称为learning schedule。 如果学习速度降低得过快, 你可能会陷入局部最小值, 甚至在到达最小值的半路就停止了。 如果学习速度降低得太慢, 你可能在最小值的附近长时间摆动, 同时如果过早停止训练, 最终只会出现次优解。
由于每个实例的选择是随机的, 有的实例可能在每一代中都被选到, 这样其他的实例也可能一直不被选到。 如果你想保证每一代迭代过程, 算法可以遍历所有实例, 一种方法是将训练集打乱重排, 然后选择一个实例, 之后再继续打乱重排, 以此类推一直进行下去。 但是这样收敛速度会非常的慢。
小批量梯度下降 最后一个梯度下降算法, 我们将介绍小批量梯度下降算法。 一旦你理解了批量梯度下降和随机梯度下降, 再去理解小批量梯度下降是非常简单的。 在迭代的每一步, 批量梯度使用整个训练集, 随机梯度时候用仅仅一个实例, 在小批量梯度下降中, 它则使用一个随机的小型实例集。 它比随机梯度的主要优点在于你可以通过矩阵运算的硬件优化得到一个较好的训练表现, 尤其当你使用 GPU 进行运算的时候。
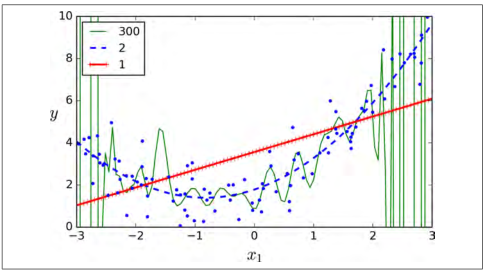
学习曲线/过拟合/欠拟合 如果你使用一个高阶的多项式回归, 你可能发现它的拟合程度要比普通的线性回归要好的多。 例如, 图4-14 使用一个 300 阶的多项式模型去拟合之前的数据集, 并同简单线性回归、 2 阶的多项式回归进行比较。 注意 300 阶的多项式模型如何摆动以尽可能接近训练实例。
当然, 这种高阶多项式回归模型在这个训练集上严重过拟合了, 线性模型则欠拟合。 在这个训练集上, 二次模型有着较好的泛化能力。 那是因为在生成数据时使用了二次模型, 但是一般我们不知道这个数据生成函数是什么, 那我们该如何决定我们模型的复杂度呢? 你如何告诉我你的模型是过拟合还是欠拟合?
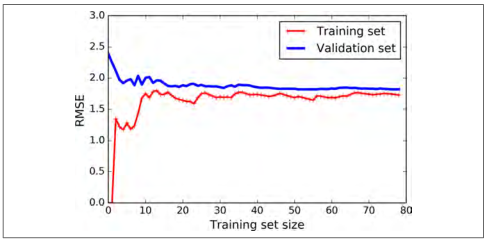
上面的曲线表现了一个典型的欠拟合模型, 两条曲线都到达高原地带并趋于稳定, 并且最后两条曲线非常接近, 同时误差值非常大。
这幅图值得我们深究。 首先, 我们观察训练集的表现: 当训练集只有一两个样本的时候, 模型能够非常好的拟合它们, 这也是为什么曲线是从零开始的原因。 但是当加入了一些新的样本的时候, 训练集上的拟合程度变得难以接受, 出现这种情况有两个原因, 一是因为数据中含有噪声, 另一个是数据根本不是线性的。 因此随着数据规模的增大, 误差也会一直增大, 直到达到高原地带并趋于稳定, 在之后, 继续加入新的样本, 模型的平均误差不会变得更好或者更差。 我们继续来看模型在验证集上的表现, 当以非常少的样本去训练时, 模型不能恰当的泛化, 也就是为什么验证误差一开始是非常大的。 当训练样本变多的到时候, 模型学习的东西变多, 验证误差开始缓慢的下降。 但是一条直线不可能很好的拟合这些数据, 因此最后误差会到达在一个高原地带并趋于稳定, 最后和训练集的曲线非常接近。
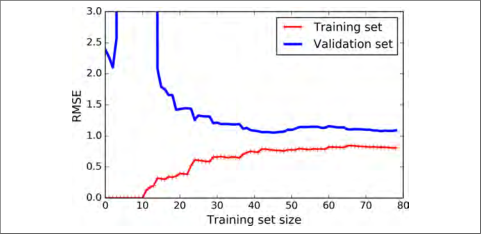
这幅图像和之前的有一点点像, 但是其有两个非常重要的不同点:
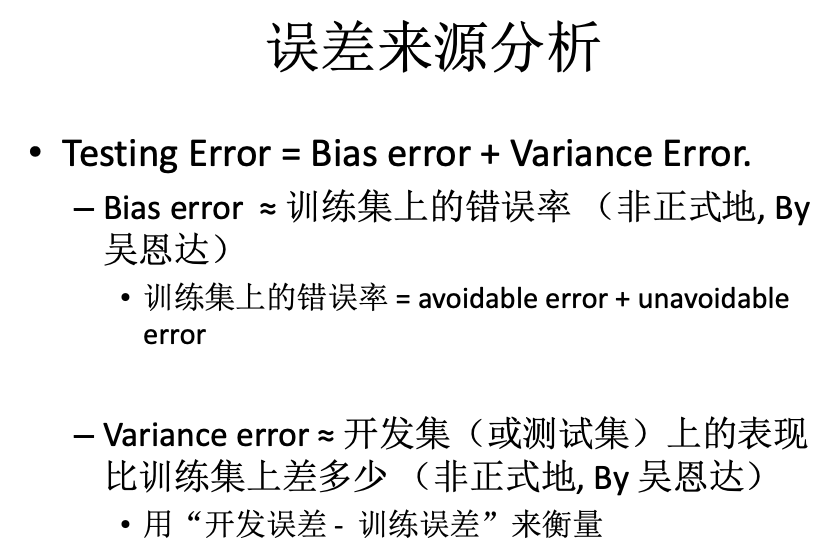
误差来源分析
改善模型过拟合的一种方法是提供更多的训练数据, 直到训练误差和验证误差相等。 在统计和机器学习领域有个重要的理论: 一个模型的泛化误差由三个不同误差的和决定:
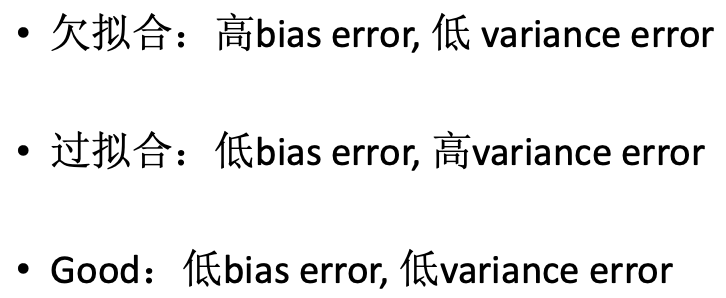
偏差: 泛化误差的这部分误差是由于错误的假设决定的。 例如实际是一个二次模型, 你却假设了一个线性模型。 一个高偏差的模型最容易出现欠拟合。
方差: 这部分误差是由于模型对训练数据的微小变化较为敏感, 一个多自由度的模型更容易有高的方差( 例如一个高阶多项式模型) , 因此会导致模型过拟合。
不可约误差: 这部分误差是由于数据本身的噪声决定的。 降低这部分误差的唯一方法就是进行数据清洗( 例如: 修复数据源, 修复坏的传感器, 识别和剔除异常值) 。
正则化 降低模型的过拟合的好方法是正则化这个模型 ( 即限制它) : 模型有越少的自由度, 就越难以拟合数据。 例如, 正则化一个多项式模型, 一个简单的方法就是减少多项式的阶数。
对于一个线性模型, 正则化的典型实现就是约束模型中参数的权重。 接下来我们将介绍三种不同约束权重的方法: Ridge 回归, Lasso 回归和 Elastic Net。
岭回归 岭回归( 也称为 Tikhonov 正则化) 是线性回归的正则化版: 在损失函数上直接加上一个正则项α Σ θ[i]^2, i = 1 -> n。 这使得学习算法不仅能够拟合数据, 而且能够使模型的参数权重尽量的小。 注意到这个正则项只有在训练过程中才会被加到损失函数。 当得到完成训练的模型后, 我们应该使用没有正则化的测量方法去评价模型的表现。
训练过程使用的损失函数和测试过程使用的评价函数是不一样的。 除了正则化, 还有一个不同: 训练时的损失函数应该在优化过程中易于求导
岭回归损失函数: 超参数α决定了你想正则化这个模型的强度。 如果α = 0那此时的岭回归便变为了线性回归。 如果α非常的大, 所有的权重最后都接近于零, 最后结果将是一条穿过数据平均值的水平直线。 对于梯度下降来说仅仅在均方差梯度向量( 公式 4-6) 加上一项αw。
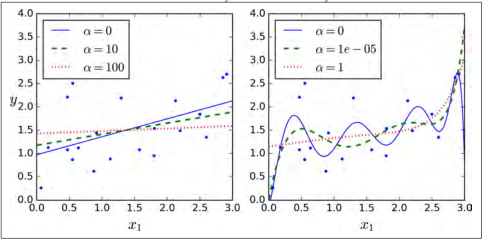
图4-17 展示了在相同线性数据上使用不同α值的岭回归模型最后的表现。 左图中, 使用简单的岭回归模型, 最后得到了线性的预测。 右图中的数据首先使用 10 阶的PolynomialFearures进行扩展, 然后使用StandardScaler进行缩放, 最后将岭模型应用在处理过后的特征上。 这就是带有岭正则项的多项式回归。 注意当α增大的时候, 导致预测曲线变得扁平( 即少了极端值, 多了一般值) , 这样减少了模型的方差, 却增加了模型的偏差。
Lasso回归 Lasso 回归( 也称 Least Absolute Shrinkage, 或者 Selection Operator Regression) 是另一种正则化版的线性回归: 就像岭回归那样, 它也在损失函数上添加了一个正则化项, 但是它使用权重向量的l1范数而不是权重向量l2范数平方的一半。 ( 如公式 4-10)
Lasso 回归的损失函数:
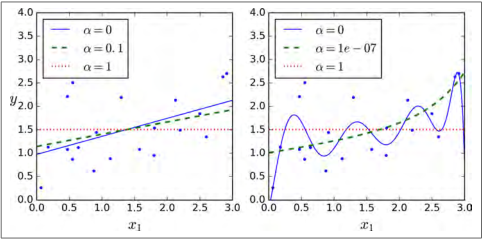
图4-18 展示了和图4-17 相同的事情, 在相同线性数据上使用不同α值的岭回归模型最后的表现。 左图中, 使用简单的岭回归模型, 最后得到了线性的预测。 右图中的数据首先使用 10 阶的PolynomialFearures进行扩展, 然后使用StandardScaler进行缩放, 最后用 Lasso 模型代替了 Ridge 模型, 同时调小了α的值。
Lasso回归的一个重要特征是它倾向于完全消除最不重要的特征的权重 ( 即将它们设置为零) 。 例如, 右图中的虚线所示( α = 10^(-7)) , 曲线看起来像一条二次曲线, 而且几乎是线性的, 这是因为所有的高阶多项特征都被设置为零。 换句话说, Lasso 回归自动的进行特征选择同时输出一个稀疏模型
弹性网络( ElasticNet) 弹性网络介于 Ridge 回归和 Lasso 回归之间。 它的正则项是 Ridge 回归和 Lasso 回归正则项的简单混合, 同时你可以控制它们的混合率r, 当r = 0时, 弹性网络就是 Ridge 回归, 当r = 1时, 其就是 Lasso 回归。 具体表示如公式 4-12。
弹性网络损失函数
那么我们该如何选择线性回归, 岭回归, Lasso 回归, 弹性网络呢? 一般来说有一点正则项的表现更好, 因此通常你应该避免使用简单的线性回归。 岭回归是一个很好的首选项, 但是如果你的特征仅有少数是真正有用的, 你应该选择 Lasso 和弹性网络。 就像我们讨论的那样, 它两能够将无用特征的权重降为零。 一般来说, 弹性网络的表现要比 Lasso 好, 因为当特征数量比样本的数量大的时候, 或者特征之间有很强的相关性时, Lasso 可能会表现的不规律。
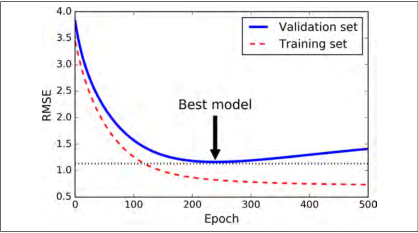
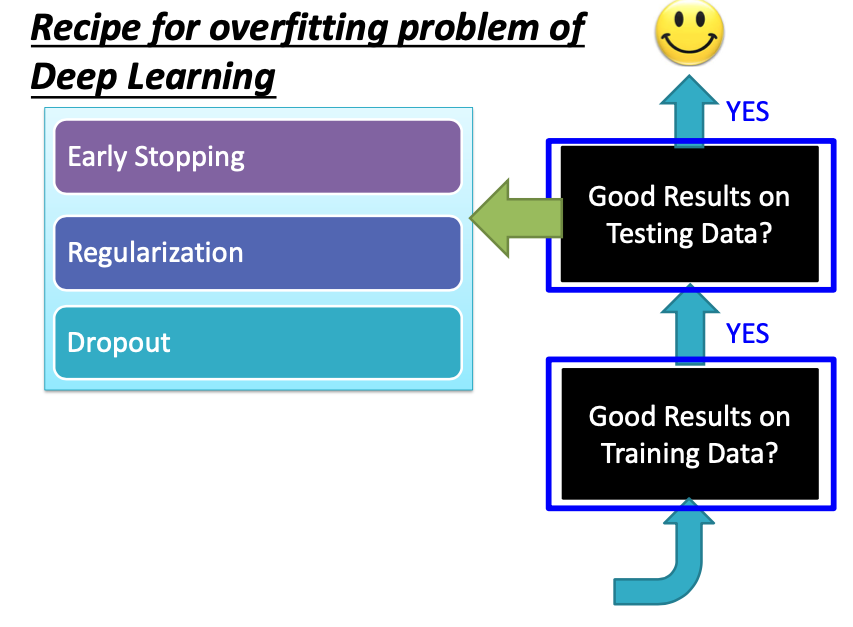
_EarlyStopping 对于迭代学习算法, 有一种非常特殊的正则化方法, 就像梯度下降在验证错误达到最小值时立即停止训练那样。 我们称为早期停止法。 图4-20 表示使用批量梯度下降来训练一个非常复杂的模型( 一个高阶多项式回归模型) 。 随着训练的进行, 算法一直学习, 它在训练集上的预测误差( RMSE) 自然而然的下降。 然而一段时间后, 验证误差停止下降, 并开始上升。 这意味着模型在训练集上开始出现过拟合。 一旦验证错误达到最小值, 便提早停止训练。
机器学习基础
支持向量机SVM 线性SVM分类 支持向量机( SVM) 是个非常强大并且有多种功能的机器学习模型, 能够做线性或者非线性的分类, 回归, 甚至异常值检测。 机器学习领域中最为流行的模型之一, 是任何学习机器学习的人必备的工具。 SVM 特别适合应用于复杂但中小规模数据集的分类问题。
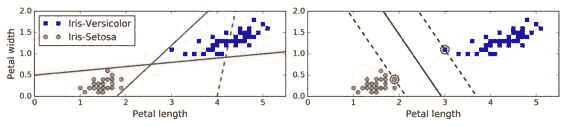
SVM 的基本思想能够用一些图片来解释得很好, 图 5-1 展示了我们在第 4 章结尾处介绍的鸢尾花数据集的一部分 这两个种类能够被非常清晰, 非常容易的用一条直线分开( 即线性可分的) 。 左边的图显示了三种可能的线性分类器的判定边界。 其中用虚线表示的线性模型判定边界很差, 甚至不能正确地划分类别。 另外两个线性模型在这个数据集表现的很好, 但是它们的判定边界很靠近样本点, 在新的数据上可能不会表现的很好。 相比之下, 右边图中 SVM 分类器的判定边界实线, 不仅分开了两种类别, 而且还尽可能地远离了最靠近的训练数据点。 你可以认为 SVM 分类器在两种类别之间保持了一条尽可能宽敞的街道( 图中平行的虚线) , 其被称为最大间隔分类。 注意到添加更多的样本点在“ 街道” 外并不会影响到判定边界, 因为判定边界是由位于“ 街道” 边缘的样本点确定的, 这些样本点被称为“ 支持向量”
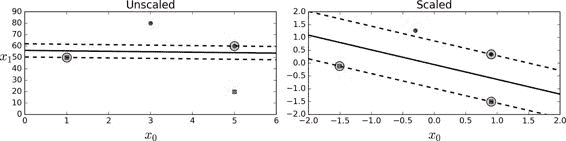
SVM 对特征缩放比较敏感, 可以看到图 5-2: 左边的图中, 垂直的比例要更大于水平的比例, 所以最宽的“ 街道” 接近水平。 但对特征缩放后( 例如使用 Scikit-Learn 的 StandardScaler) , 判定边界看起来要好得多, 如右图。
软间隔分类 如果我们严格地规定所有的数据都不在“ 街道” 上, 都在正确地两边, 称为硬间隔分类. 硬间隔分类有两个问题
只对线性可分的数据起作用,
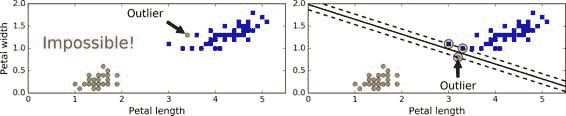
对异常点敏感。 图 5-3 显示了只有一个异常点的鸢尾花数据集: 左边的图中很难找到硬间隔, 右边的图中判定边界和我们之前在图 5-1 中没有异常点的判定边界非常不一样, 它很难一般化。
为了避免上述的问题, 我们更倾向于使用更加软性的模型。 目的在保持“ 街道” 尽可能大和避免间隔违规( 例如: 数据点出现在“ 街道” 中央或者甚至在错误的一边) 之间找到一个良好的平衡。 这就是软间隔分类。
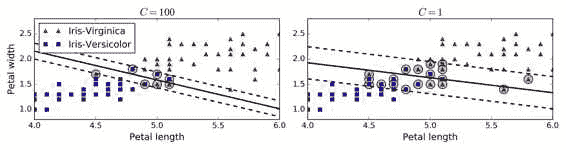
在 Scikit-Learn 库的 SVM 类, 你可以用C超参数( 惩罚系数) 来控制这种平衡: 较小的C会导致更宽的“ 街道” , 但更多的间隔违规。 图 5-4 显示了在非线性可分隔的数据集上, 两个软间隔 SVM 分类器的判定边界。 左边图中, 使用了较大的C值, 导致更少的间隔违规, 但是间隔较小。 右边的图, 使用了较小的C值, 间隔变大了, 但是许多数据点出现在了“ 街道” 上。 然而, 第二个分类器似乎泛化地更好: 事实上, 在这个训练数据集上减少了预测错误, 因为实际上大部分的间隔违规点出现在了判定边界正确的一侧。
如果你的 SVM 模型过拟合, 你可以尝试通过减小超参数C去调整。
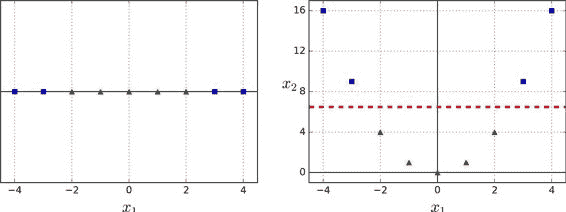
非线性SVM分类 尽管线性 SVM 分类器在许多案例上表现得出乎意料的好, 但是很多数据集并不是线性可分的。 一种处理非线性数据集方法是增加更多的特征, 例如多项式特征( 正如你在第 4 章所做的那样) ; 在某些情况下可以变成线性可分的数据。 在图 5-5 的左图中, 它只有一个特征x1的简单的数据集, 正如你看到的, 该数据集不是线性可分的。 但是如果你增加了第二个特征 x2=(x1)^2, 产生的 2D 数据集就能很好的线性可分。
为了实施这个想法, 通过 Scikit-Learn, 你可以创建一个流水线( Pipeline) 去包含多项式特征( PolynomialFeatures) 变换( 在 121 页的“ Polynomial Regression” 中讨论) , 然后一个StandardScaler和LinearSVC。
from sklearn.datasets import make_moonsfrom sklearn.pipeline import Pipelinefrom sklearn.preprocessing import PolynomialFeaturespolynomial_svm_clf = Pipeline(( ("poly_features" , PolynomialFeatures(degree=3 )), ("scaler" , StandardScaler()), ("svm_clf" , LinearSVC(C=10 , loss="hinge" )) )) polynomial_svm_clf.fit(X, y)
多项式核 添加多项式特征很容易实现, 不仅仅在 SVM, 在各种机器学习算法都有不错的表现, 但是低次数的多项式不能处理非常复杂的数据集, 而高次数的多项式却产生了大量的特征, 会使模型变得慢。
幸运的是, 当你使用 SVM 时, 你可以运用一个被称为“ 核技巧” ( kernel trick) 的神奇数学技巧。 它可以取得就像你添加了许多多项式, 甚至有高次数的多项式, 一样好的结果。 所以不会大量特征导致的组合爆炸, 因为你并没有增加任何特征。
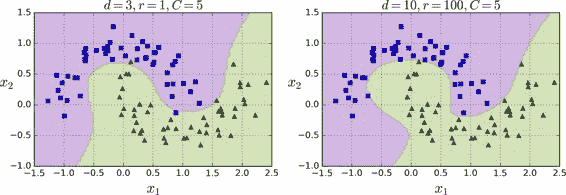
from sklearn.svm import SVCpoly_kernel_svm_clf = Pipeline(( ("scaler" , StandardScaler()), ("svm_clf" , SVC(kernel="poly" , degree=3 , coef0=1 , C=5 )) )) poly_kernel_svm_clf.fit(X, y)
3 阶的多项式核训练了一个 SVM 分类器, 即图 5-7 的左图。 右图是使用了 10 阶的多项式核 SVM 分类器。 很明显, 如果你的模型过拟合, 你可以减小多项式核的阶数。 相反的, 如果是欠拟合, 你可以尝试增大它。 超参数coef0控制了高阶多项式与低阶多项式对模型的影响。
通用的方法是用网格搜索( grid search 见第 2 章) 去找到最优超参数。 首先进行非常粗略的网格搜索一般会很快, 然后在找到的最佳值进行更细的网格搜索。
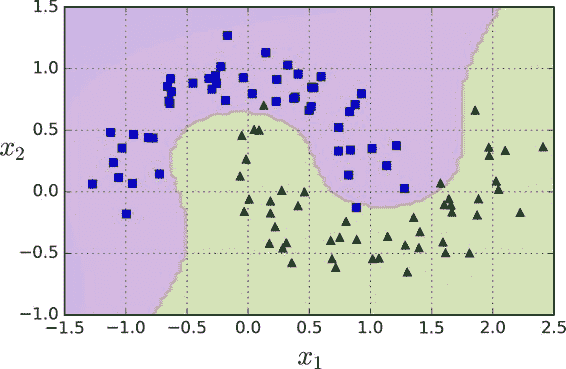
增加相似特征 另一种解决非线性问题的方法是使用相似函数( similarity funtion) 计算每个样本与特定地标( landmark) 的相似度。 例如, 让我们来看看前面讨论过的一维数据集, 并在x1=-2和x1=1之间增加两个地标( 图 5-8 左图) 。 接下来, 我们定义一个相似函数, 即高斯径向基函数( Gaussian Radial Basis Function, RBF) , 设置γ = 0.3( 见公式 5-1)
你可能想知道如何选择地标。 最简单的方法是在数据集中的每一个样本的位置创建地标。 这将产生更多的维度从而增加了转换后数据集是线性可分的可能性。 但缺点是, m个样本, n个特征的训练集被转换成了m个实例, m个特征的训练集( 假设你删除了原始特征) 。 这样一来, 如果你的训练集非常大, 你最终会得到同样大的特征。
高斯 RBF 核 就像多项式特征法一样, 相似特征法对各种机器学习算法同样也有不错的表现。 但是在所有额外特征上的计算成本可能很高, 特别是在大规模的训练集上。 然而, “ 核” 技巧再一次显现了它在 SVM 上的神奇之处: 高斯核让你可以获得同样好的结果成为可能, 就像你在相似特征法添加了许多相似特征一样, 但事实上, 你并不需要在 RBF 添加它们。 我们使用 SVC 类的高斯 RBF 核来检验一下。
rbf_kernel_svm_clf = Pipeline(( ("scaler" , StandardScaler()), ("svm_clf" , SVC(kernel="rbf" , gamma=5 , C=0.001 )) )) rbf_kernel_svm_clf.fit(X, y)
这个模型在图 5-9 的左下角表示。 其他的图显示了用不同的超参数gamma (γ)和C训练的模型。 增大γ使钟型曲线更窄( 图 5-8 左图) , 导致每个样本的影响范围变得更小: 即判定边界最终变得更不规则, 在单个样本周围环绕。 相反的, 较小的γ值使钟型曲线更宽, 样本有更大的影响范围, 判定边界最终则更加平滑。 所以γ是可调整的超参数: 如果你的模型过拟合, 你应该减小γ值, 若欠拟合, 则增大γ( 与超参数C相似) 。
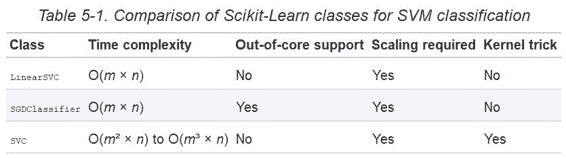
计算复杂度 LinearSVC类基于liblinear库, 它实现了线性 SVM 的优化算法。 它并不支持核技巧, 但是它样本和特征的数量几乎是线性的: 训练时间复杂度大约为O(m × n)。
如果你要非常高的精度, 这个算法需要花费更多时间。 这是由容差值超参数ϵ( 在 Scikit-learn 称为tol) 控制的。 大多数分类任务中, 使用默认容差值的效果是已经可以满足一般要求。
SVC 类基于libsvm库, 它实现了支持核技巧的算法。 训练时间复杂度通常介于 O(m^2 × n)和O(m^3 × n)之间. 不幸的是, 这意味着当训练样本变大时, 它将变得极其慢( 例如, 成千上万个样本) 。 这个算法对于复杂但小型或中等数量的数据集表现是完美的。 然而, 它能对特征数量很好的缩放, 尤其对稀疏特征来说( sparse features) ( 即每个样本都有一些非零特征) 。 在这个情况下, 算法对每个样本的非零特征的平均数量进行大概的缩放。
表 5-1 对 Scikit-learn 的 SVM 分类模型进行比较。
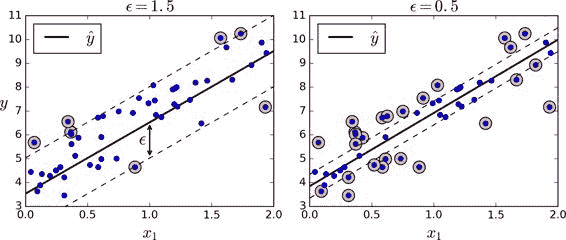
SVM回归 SVM 算法应用广泛: 不仅仅支持线性和非线性的分类任务, 还支持线性和非线性的回归任务。 SVM回归核心在于逆转我们的目标: 限制间隔违规的情况下, 不是试图在两个类别之间找到尽可能大的“ 街道” ( 即间隔) 。 SVM 回归任务是限制间隔违规情况下, 尽量放置更多的样本在“ 街道” 上。 “ 街道” 的宽度由超参数ϵ控制。 图 5-10 显示了在一些随机生成的线性数据上, 两个线性 SVM 回归模型的训练情况。 一个有较大的间隔( ϵ=1.5) , 另一个间隔较小( ϵ=0.5)
你可以使用 Scikit-Learn 的LinearSVR类去实现线性 SVM 回归。 下面的代码产生的模型在图 5-10 左图( 训练数据需要被中心化和标准化)
from sklearn.svm import LinearSVRsvm_reg = LinearSVR(epsilon=1.5 ) svm_reg.fit(X, y)
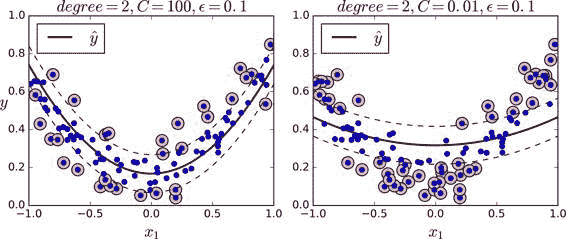
处理非线性回归任务, 你可以使用核化的 SVM 模型。 比如, 图 5-11 显示了在随机二次方的训练集, 使用二次方多项式核函数的 SVM 回归。 左图是较小的正则化( 即更大的C值) , 右图则是更大的正则化( 即小的C值)
from sklearn.svm import SVRsvm_poly_reg = SVR(kernel="poly" , degree=2 , C=100 , epsilon=0.1 ) svm_poly_reg.fit(X, y)
决策树 和支持向量机一样, 决策树是一种多功能机器学习算法, 即可以执行分类任务也可以执行回归任务, 甚至包括多输出( multioutput) 任务.它是一种功能很强大的算法, 可以对很复杂的数据集进行拟合。 例如, 在第二章中我们对加利福尼亚住房数据集使用决策树回归模型进行训练, 就很好的拟合了数据集( 实际上是过拟合) 。 决策树也是随机森林的基本组成部分( 见第 7 章) , 而随机森林是当今最强大的机器学习算法之一。
分类 理解决策树, 我们需要先构建一个决策树并亲身体验它到底如何进行预测。 接下来的代码就是在我们熟知的鸢尾花数据集上进行一个决策树分类器的训练
from sklearn.datasets import load_irisfrom sklearn.tree import DecisionTreeClassifieriris = load_iris() X = iris.data[:, 2 :] y = iris.target tree_clf = DecisionTreeClassifier(max_depth=2 ) tree_clf.fit(X, y)
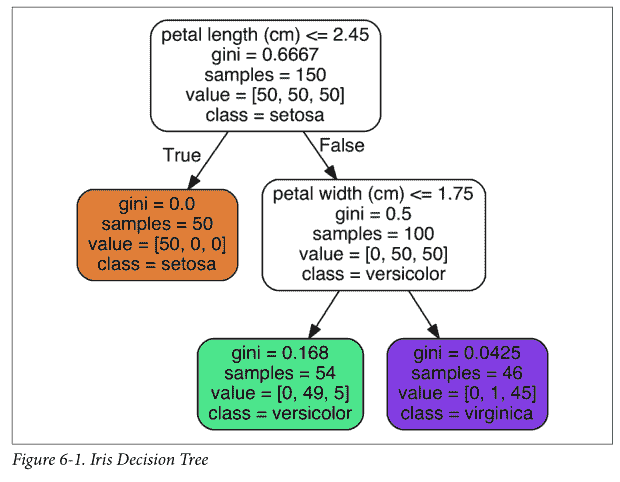
我们的第一个决策树如图 6-1。
决策树的众多特性之一就是, 它不需要太多的数据预处理, 尤其是不需要进行特征的缩放或者归一化。
现在让我们来看看在图 6-1 中的树是如何进行预测的。 假设你找到了一朵鸢尾花并且想对它进行分类, 你从根节点开始( 深度为 0, 顶部) : 该节点询问花朵的花瓣长度是否小于 2.45 厘米。 如果是, 您将向下移动到根的左侧子节点( 深度为 1, 左侧) 。 在这种情况下, 它是一片叶子节点( 即它没有任何子节点) , 所以它不会问任何问题: 你可以方便地查看该节点的预测类别, 决策树预测你的花是 Iris-Setosa( class = setosa) 。
现在假设你找到了另一朵花, 但这次的花瓣长度是大于 2.45 厘米的。 你必须向下移动到根的右侧子节点( 深度为 1, 右侧) , 而这个节点不是叶节点, 所以它会问另一个问题: 花瓣宽度是否小于 1.75 厘米? 如果是, 那么你的花很可能是一个 Iris-Versicolor( 深度为 2, 左) 。 如果不是, 那很可能一个 Iris-Virginica( 深度为 2, 右)
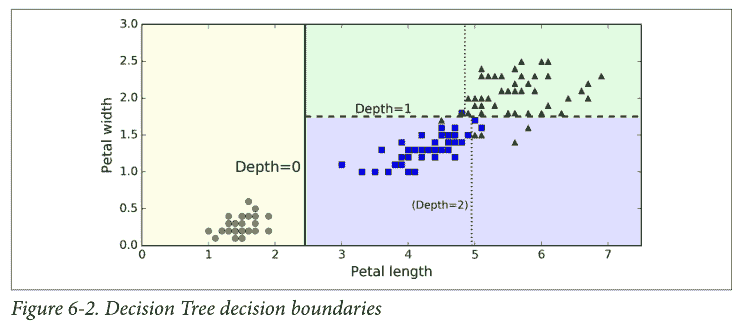
图 6-2 显示了决策树的决策边界。 粗的垂直线代表根节点( 深度为 0) 的决定边界: 花瓣长度为 2.45 厘米。 由于左侧区域是纯的( 只有 Iris-Setosa) , 所以不能再进一步分裂。 然而, 右边的区域是不纯的, 所以深度为 1 的右边节点在花瓣宽度为 1.75 厘米处分裂( 用虚线表示) 。 又由于max_depth设置为 2, 决策树在那里停了下来。 但是, 如果将max_depth设置为 3, 两个深度为 2 的节点, 每个都将会添加另一个决策边界( 用虚线表示) 。
决策树非常直观, 他们的决定很容易被解释。 这种模型通常被称为白盒模型。 相反, 随机森林或神经网络通常被认为是黑盒模型。 他们能做出很好的预测, 并且您可以轻松检查它们做出这些预测过程中计算的执行过程。 然而, 人们通常很难用简单的术语来解释为什么模型会做出这样的预测。
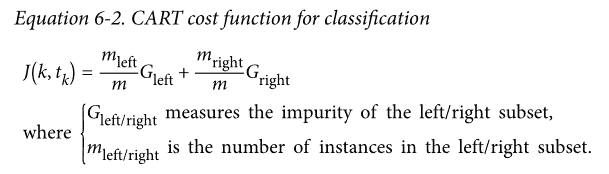
_CART训练算法 Scikit-Learn 用分裂回归树( Classification And Regression Tree, 简称 CART) 算法训练决策树( 也叫“ 增长树” ) 。 这种算法思想真的非常简单: 首先使用单个特征k和阈值t[k]( 例如, “ 花瓣长度≤2.45cm” ) 将训练集分成两个子集。 它如何选择k和t[k]呢? 它寻找到能够产生最纯粹的子集一对(k, t[k]), 然后通过子集大小加权计算。 算法会尝试最小化成本函数。
当它成功的将训练集分成两部分之后, 它将会继续使用相同的递归式逻辑继续的分割子集, 然后是子集的子集。 当达到预定的最大深度之后将会停止分裂( 由max_depth超参数决定) , 或者是它找不到可以继续降低不纯度的分裂方法的时候。 几个其他超参数( min_samples_split, min_samples_leaf, min_weight_fraction_leaf, max_leaf_nodes) 。 控制了其他的停止生长条件
找到最优树是一个 NP 完全问题( 自行百度) : 它需要O(exp^m)时间, 即使对于相当小的训练集也会使问题变得棘手。 这就是为什么我们必须设置一个“ 合理的” ( 而不是最佳的) 解决方案。
在建立好决策树模型后, 做出预测需要遍历决策树, 从根节点一直到叶节点。 决策树通常近似左右平衡, 因此遍历决策树需要经历大致O(log2(m)) 个节点。 由于每个节点只需要检查一个特征的值, 因此总体预测复杂度仅为O(log2(m)), 与特征的数量无关。 所以即使在处理大型训练集时, 预测速度也非常快。
然而, 训练算法的时候( 训练和预测不同) 需要比较所有特征( 如果设置了max_features会更少一些)
在每个节点的所有样本上。 就有了O(n×m log(m))的训练复杂度。 对于小型训练集( 少于几千例) , Scikit-Learn 可以通过预先设置数据( presort = True) 来加速训练, 但是这对于较大训练集来说会显着减慢训练速度
正则化 如果不添加约束, 树结构模型通常将根据训练数据调整自己, 使自身能够很好的拟合数据, 而这种情况下大多数会导致模型过拟合。
DecisionTreeClassifier类还有一些其他的参数用于限制树模型的形状:
min_samples_split( 节点在被分裂之前必须具有的最小样本数) , min_samples_leaf( 叶节点必须具有的最小样本数) , min_weight_fraction_leaf( 和min_samples_leaf相同, 但表示为加权总数的一小部分实例) , max_leaf_nodes( 叶节点的最大数量) 和 max_features( 在每个节点被评估是否分裂的时候, 具有的最大特征数量) 。 增加min_* hyperparameters或者减少max_* hyperparameters会使模型正则化。
一些其他算法的工作原理是在没有任何约束条件下训练决策树模型, 让模型自由生长, 然后再对不需要的节点进行剪枝。
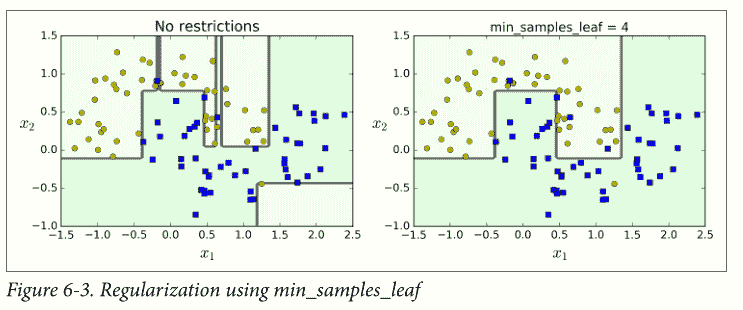
图 6-3 显示了对moons数据集( 在第 5 章介绍过) 进行训练生成的两个决策树模型, 左侧的图形对应的决策树使用默认超参数生成( 没有限制生长条件) , 右边的决策树模型设置为min_samples_leaf=4。 很明显, 左边的模型过拟合了, 而右边的模型泛用性更好。
回归 决策树也能够执行回归任务, 让我们使用 Scikit-Learn 的DecisionTreeRegressor类构建一个回归树, 让我们用max_depth = 2在具有噪声的二次项数据集上进行训练。
from sklearn.tree import DecisionTreeRegressortree_reg = DecisionTreeRegressor(max_depth=2 ) tree_reg.fit(X, y)
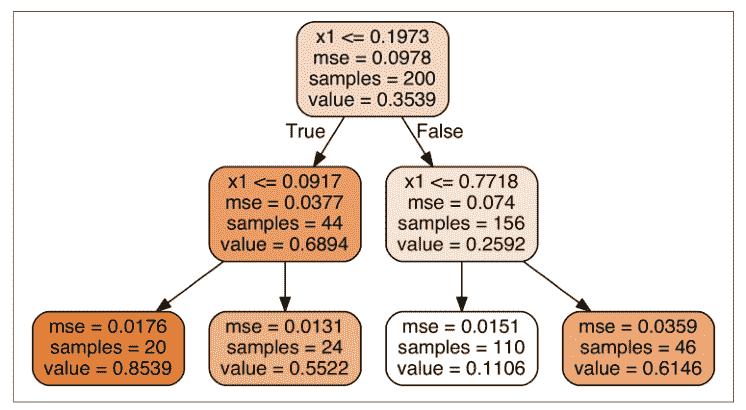
这棵树看起来非常类似于你之前建立的分类树, 它的主要区别在于, 它不是预测每个节点中的样本所属的分类, 而是预测一个具体的数值。 例如, 假设您想对x[1] = 0.6的新实例进行预测。 从根开始遍历树, 最终到达预测值等于 0.1106 的叶节点。 该预测仅仅是与该叶节点相关的 110 个训练实例的平均目标值。 而这个预测结果在对应的 110 个实例上的均方误差( MSE) 等于 0.0151。
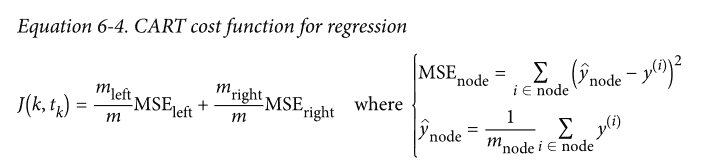
CART 算法的工作方式与之前处理分类模型基本一样, 不同之处在于, 现在不再以最小化不纯度的方式分割训练集, 而是试图以最小化 MSE 的方式分割训练集。 公式 6-4 显示了成本函数, 该算法试图最小化这个成本函数。
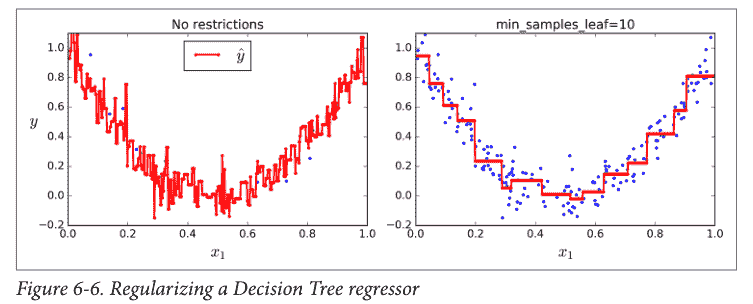
和处理分类任务时一样, 决策树在处理回归问题的时候也容易过拟合。 如果不添加任何正则化( 默认的超参数) , 你就会得到图 6-6 左侧的预测结果, 显然, 过度拟合的程度非常严重。 而当我们设置了min_samples_leaf = 10, 相对就会产生一个更加合适的模型了, 就如图 6-6 所示的那样。
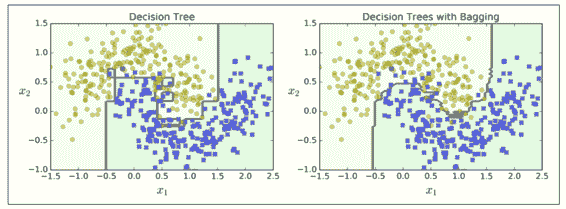
不稳定性 它很容易理解和解释, 易于使用且功能丰富而强大。 然而, 它也有一些限制, 首先, 你可能已经注意到了, ==决策树很喜欢设定正交化的决策边界, ==( 所有边界都是和某一个轴相垂直的) , 这使得它对训练数据集的旋转很敏感, 例如图 6-7 显示了一个简单的线性可分数据集。 在左图中, 决策树可以轻易的将数据分隔开, 但是在右图中, 当我们把数据旋转了 45° 之后, 决策树的边界看起来变的格外复杂。 尽管两个决策树都完美的拟合了训练数据, 右边模型的泛化能力很可能非常差。 解决这个难题的一种方式是使用 PCA 主成分分析( 第八章) , 这样通常能使训练结果变得更好一些。
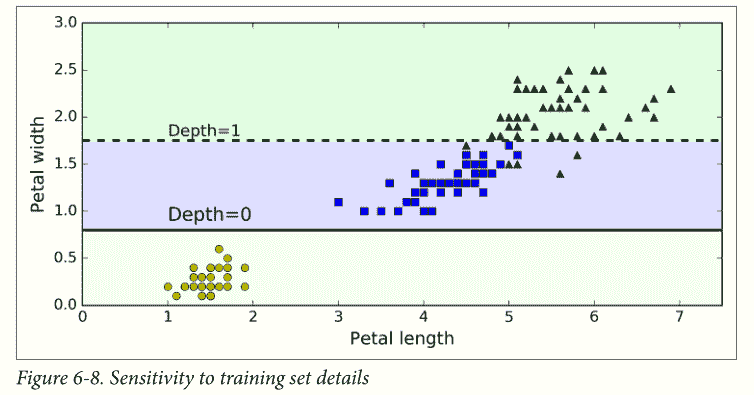
更加通俗的讲, ==决策时的主要问题是它对训练数据的微小变化非常敏感, ==举例来说, 我们仅仅从鸢尾花训练数据中将最宽的 Iris-Versicolor 拿掉( 花瓣长 4.8 厘米, 宽 1.8 厘米) , 然后重新训练决策树模型, 你可能就会得到图 6-8 中的模型。 正如我们看到的那样, 决策树有了非常大的变化( 原来的如图 6-2) , 事实上, 由于 Scikit-Learn 的训练算法是非常随机的, 即使是相同的训练数据你也可能得到差别很大的模型( 除非你设置了随机数种子) 。
集成学习/随机森林 假设你去随机问很多人一个很复杂的问题, 然后把它们的答案合并起来。 通常情况下你会发现这个合并的答案比一个专家的答案要好。 这就叫做_群体智慧_。 同样的, 如果你合并了一组分类器的预测( 像分类或者回归) , 你也会得到一个比单一分类器更好的预测结果。 这一组分类器就叫做集成; 因此, 这个技术就叫做集成学习, 一个集成学习算法就叫做集成方法。
你可以训练一组决策树分类器, 每一个都在一个随机的训练集上。 为了去做预测, 你必须得到所有单一树的预测值, 然后通过投票( 例如第六章的练习) 来预测类别。 例如一种决策树的集成就叫做随机森林, 它除了简单之外也是现今存在的最强大的机器学习算法之一。
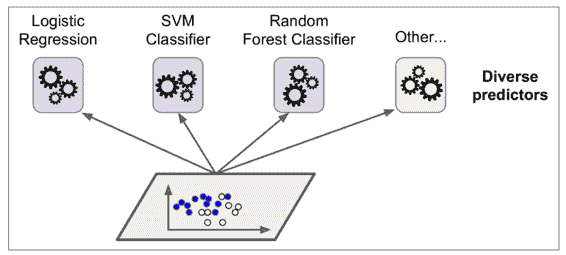
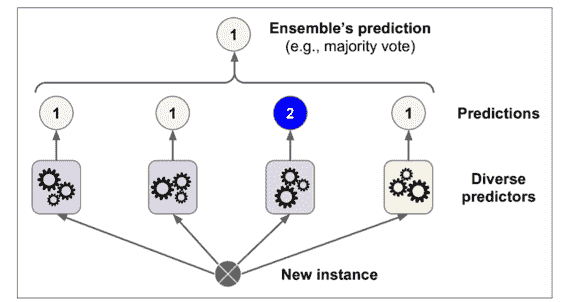
投票(分类) 假设你已经训练了一些分类器, 每一个都有 80% 的准确率。 你可能有了一个逻辑斯蒂回归、 或一个 SVM、 或一个随机森林, 或者一个 KNN, 或许还有更多( 详见图 7-1) 一个非常简单去创建一个更好的分类器的方法就是去整合每一个分类器的预测然后经过投票去预测分类。 这种分类器就叫做硬投票分类器( 详见图 7-2) 。 令人惊奇的是这种投票分类器得出的结果经常会比集成中最好的一个分类器结果更好。 事实上, 即使每一个分类器都是一个弱学习器( 意味着它们也就比瞎猜好点) , 集成后仍然是一个强学习器( 高准确率) , 只要有足够数量的弱学习者, 他们就足够多样化。
>>> from sklearn.ensemble import RandomForestClassifier >>> from sklearn.ensemble import VotingClassifier >>> from sklearn.linear_model import LogisticRegression >>> from sklearn.svm import SVC>>> log_clf = LogisticRegression() >>> rnd_clf = RandomForestClassifier() >>> svm_clf = SVC()>>> voting_clf = VotingClassifier(estimators=[('lr' , log_clf), ('rf' , rnd_clf), >>> ('svc' , svm_clf)],voting='hard' ) >>> voting_clf.fit(X_train, y_train)
>>> from sklearn.metrics import accuracy_score >>> for clf in (log_clf, rnd_clf, svm_clf, voting_clf): >>> clf.fit(X_train, y_train) >>> y_pred = clf.predict(X_test) >>> print (clf.__class__.__name__, accuracy_score(y_test, y_pred)) LogisticRegression 0.864 RandomForestClassifier 0.872 SVC 0.888 VotingClassifier 0.896
如果所有的分类器都能够预测类别的概率( 例如他们有一个predict_proba()方法) , 那么你就可以让 sklearn 以最高的类概率来预测这个类, 平均在所有的分类器上。 这种方式叫做软投票。 他经常比硬投票表现的更好, 因为它给予高自信的投票更大的权重。 你可以通过把voting="hard"设置为voting="soft"来保证分类器可以预测类别概率。
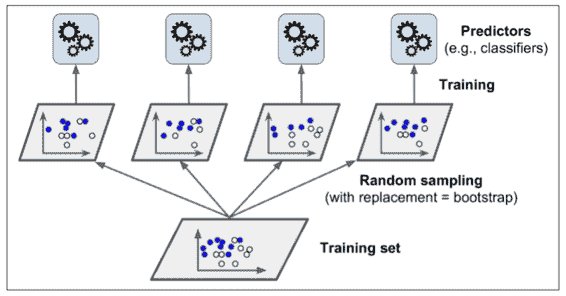
Bagging & Pasting 可以通过使用不同的训练算法去得到一些不同的分类器。 另一种方法就是对每一个分类器都使用相同的训练算法, 但是在不同的训练集上去训练它们。 有放回采样被称为装袋( Bagging , 是 bootstrap aggregating 的缩写) 。 无放回采样称为粘贴( pasting ) 。 Bagging 和 Pasting 都允许在多个分类器上对训练集进行多次采样, 但只有 Bagging 允许对同一种分类器上对训练集进行进行多次采样。 采样和训练过程如图 7-4 所示。
当所有的分类器被训练后, 集成可以通过对所有分类器结果的简单聚合来对新的实例进行预测。 聚合函数通常对分类是_统计模式_( 例如硬投票分类器) 或者对回归是平均。 每一个单独的分类器在如果在原始训练集上都是高偏差, 但是聚合降低了偏差和方差。 通常情况下, 集成的结果是有一个相似的偏差, 但是对比与在原始训练集上的单一分类器来讲有更小的方差。
分类器可以通过不同的 CPU 核或其他的服务器一起被训练。 相似的, 分类器也可以一起被制作。 这就是为什么 Bagging 和 Pasting 是如此流行的原因之一: 它们的可扩展性很好。
sklearn 为 Bagging 和 Pasting 提供了一个简单的 API: BaggingClassifier类( 或者对于回归可以是BaggingRegressor。 接下来的代码训练了一个 500 个决策树分类器的集成, 每一个都是在数据集上有放回采样 100 个训练实例下进行训练( 这是 Bagging 的例子, 如果你想尝试 Pasting, 就设置bootstrap=False) 。 n_jobs参数告诉 sklearn 用于训练和预测所需要 CPU 核的数量。 ( -1 代表着 sklearn 会使用所有空闲核) :
>>>from sklearn.ensemble import BaggingClassifier >>>from sklearn.tree import DecisionTreeClassifier >>>bag_clf = BaggingClassifier(DecisionTreeClassifier(), n_estimators=500 , >>> max_samples=100 , bootstrap=True , n_jobs=-1 ) >>>bag_clf.fit(X_train, y_train) >>>y_pred = bag_clf.predict(X_test)
Bootstrap 在每个预测器被训练的子集中引入了更多的分集, 所以 Bagging 结束时的偏差比 Pasting 更高, 但这也意味着预测因子最终变得不相关, 从而减少了集合的方差。 总体而言, Bagging 通常会导致更好的模型, 这就解释了为什么它通常是首选的。
对于 Bagging 来说, 一些实例可能被一些分类器重复采样, 但其他的有可能不会被采样。 BaggingClassifier默认采样。 BaggingClassifier默认是有放回的采样m个实例 ( bootstrap=True) , 其中m是训练集的大小, 这意味着平均下来只有 63% 的训练实例被每个分类器采样, 剩下的 37% 个==没有被采样的训练实例就叫做 Out-of-Bag 实例。 ==
在 sklearn 中, 你可以在训练后需要创建一个BaggingClassifier来自动评估时设置oob_score=True来自动评估。 接下来的代码展示了这个操作。 评估结果通过变量oob_score_来显示:
>>> bag_clf = BaggingClassifier(DecisionTreeClassifier(), n_estimators=500 ,bootstrap=True , n_jobs=-1 , oob_score=True )>>> bag_clf.fit(X_train, y_train) >>> bag_clf.oob_score_ 0.93066666666666664
随机森林 正如我们所讨论的, 随机森林是决策树的一种集成 , 通常是通过 bagging 方法( 有时是 pasting 方法) 进行训练, 通常用max_samples设置为训练集的大小。 与建立一个BaggingClassifier然后把它放入DecisionTreeClassifier相反, 你可以使用更方便的也是对决策树优化够的RandomForestClassifier( 对于回归是RandomForestRegressor) 。 接下来的代码训练了带有 500 个树( 每个被限制为 16 叶子结点) 的决策森林
>>>from sklearn.ensemble import RandomForestClassifier >>>rnd_clf = RandomForestClassifier(n_estimators=500 , max_leaf_nodes=16 , n_jobs=-1 ) >>>rnd_clf.fit(X_train, y_train) >>>y_pred_rf = rnd_clf.predict(X_test)
除了一些例外, RandomForestClassifier使用DecisionTreeClassifier的所有超参数( 决定数怎么生长) , 把BaggingClassifier的超参数加起来来控制集成本身。 随机森林算法在树生长时引入了额外的随机; 与在节点分裂时需要找到最好分裂特征相反( 详见第六章) , 它在一个随机的特征集中找最好的特征。 它导致了树的差异性, 并且再一次用高偏差换低方差, 总的来说是一个更好的模型。
极随机树 当你在随机森林上生长树时, 在每个结点分裂时只考虑随机特征集上的特征( 正如之前讨论过的一样) 。 相比于找到更好的特征我们可以通过使用对特征使用随机阈值使树更加随机( 像规则决策树一样) 。 这种极随机的树被简称为 Extremely Randomized Trees ( 极随机树) , 或者更简单的称为 Extra-Tree 。 再一次用高偏差换低方差。 它还使得 Extra-Tree 比规则的随机森林更快地训练, 因为在每个节点上找到每个特征的最佳阈值是生长树最耗时的任务之一。
最后, 如果你观察一个单一决策树, 重要的特征会出现在更靠近根部的位置, 而不重要的特征会经常出现在靠近叶子的位置。 因此我们可以通过计算一个特征在森林的全部树中出现的平均深度来预测特征的重要性。 sklearn 在训练后会自动计算每个特征的重要度。 你可以通过feature_importances_变量来查看结果。
>>> from sklearn.datasets import load_iris >>> iris = load_iris() >>> rnd_clf = RandomForestClassifier(n_estimators=500 , n_jobs=-1 ) >>> rnd_clf.fit(iris["data" ], iris["target" ]) >>> for name, score in zip (iris["feature_names" ], rnd_clf.feature_importances_): >>> print (name, score) sepal length (cm) 0.112492250999 sepal width (cm) 0.0231192882825 petal length (cm) 0.441030464364 petal width (cm) 0.423357996355
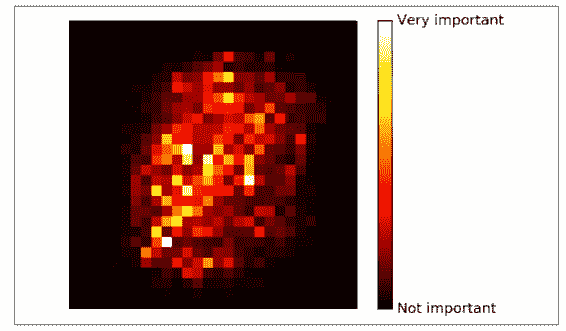
相似的, 如果你在 MNIST 数据及上训练随机森林分类器( 在第三章上介绍) , 然后画出每个像素的重要性, 你可以得到图 7-6 的图片。
Boosting 提升( Boosting, 最初称为 假设增强 ) 指的是可以将几个弱学习者组合成强学习者的集成方法。 对于大多数的提升方法的思想就是按顺序去训练分类器, 每一个都要尝试修正前面的分类。 现如今已经有很多的提升方法了, 但最著名的就是 Adaboost ( 适应性提升, 是 Adaptive Boosting 的简称) 和 Gradient Boosting ( 梯度提升) 。 让我们先从 Adaboost 说起。
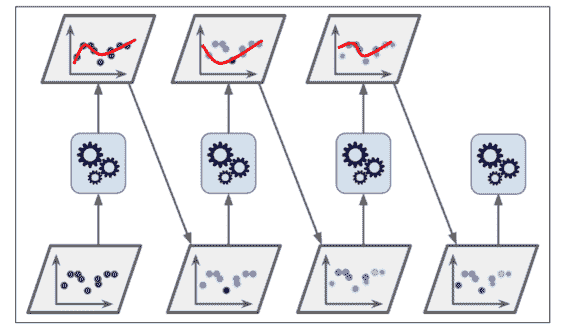
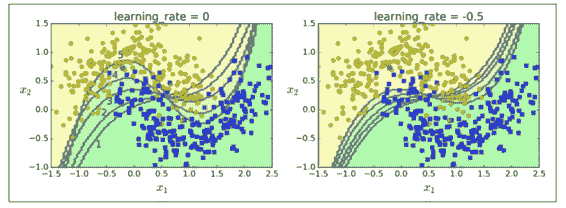
AdaBoost 使一个新的分类器去修正之前分类结果的方法就是对之前分类结果不对的训练实例多加关注。 这导致新的预测因子越来越多地聚焦于这种情况。 这是 Adaboost 使用的技术。 举个例子, 去构建一个 Adaboost 分类器, 第一个基分类器( 例如一个决策树) 被训练然后在训练集上做预测, 在误分类训练实例上的权重就增加了。 第二个分类机使用更新过的权重然后再一次训练, 权重更新, 以此类推( 详见图 7-7)
一旦所有的分类器都被训练后, 除了分类器根据整个训练集上的准确率被赋予的权重外, 集成预测就非常像 Bagging 和 Pasting 了。 序列学习技术的一个重要的缺点就是: 它不能被并行化( 只能按步骤) , 因为每个分类器只能在之前的分类器已经被训练和评价后再进行训练。 因此, 它不像 Bagging 和 Pasting 一样。
让我们详细看一下 Adaboost 算法。
每一个实例的权重wi初始都被设为1/m第一个分类器被训练, 然后他的权重误差率r1在训练集上算出, 详见公式 7-1。 其中y_tilde[j]^(i)是第j个分类器对于第i实例的预测。
实例的权重
分类器的权重α[j]随后用公式 7-2 计算出来。 其中η是超参数学习率( 默认为 1) 。 分类器准确率越高, 它的权重就越高。 如果它只是瞎猜, 那么它的权重会趋近于 0。 然而, 如果它总是出错( 比瞎猜的几率都低) , 它的权重会使负数。
分类器的权重
接下来实例的权重会按照公式 7-3 更新: 误分类的实例权重会被提升。
权重更新规则
随后所有实例的权重都被归一化( 例如被Σ w[i], i = 1 -> m整除) 最后, 一个新的分类器通过更新过的权重训练, 整个过程被重复( 新的分类器权重被计算, 实例的权重被更新, 随后另一个分类器被训练, 以此类推) 。 当规定的分类器数量达到或者最好的分类器被找到后算法就会停止。 为了进行预测, Adaboost 通过分类器权重α[j]简单的计算了所有的分类器和权重。 预测类别会是权重投票中主要的类别。 ( 详见公式 7-4) 其中N是分类器的数量。
AdaBoost 分类器 下来的代码训练了使用 sklearn 的AdaBoostClassifier基于 200 个决策树桩 Adaboost 分类器( 正如你说期待的, 对于回归也有AdaBoostRegressor) 。 一个决策树桩是max_depth=1的决策树 是一个单一的决策节点加上两个叶子结点。 这就是AdaBoostClassifier的默认基分类器:
>>>from sklearn.ensemble import AdaBoostClassifier >>>ada_clf = AdaBoostClassifier(DecisionTreeClassifier(max_depth=1 ), n_estimators=200 ,algorithm="SAMME.R" , learning_rate=0.5 ) >>>ada_clf.fit(X_train, y_train)
梯度提升 另一个非常著名的提升算法是梯度提升。 与 Adaboost 一样, 梯度提升也是通过向集成中逐步增加分类器运行的, 每一个分类器都修正之前的分类结果。 然而, 它并不像 Adaboost 那样每一次迭代都更改实例的权重, 这个方法是去使用新的分类器去拟合前面分类器预测的 残差 。
GradientBoostingRegressor也支持指定用于训练每棵树的训练实例比例的超参数subsample。 例如如果subsample=0.25, 那么每个树都会在 25% 随机选择的训练实例上训练。 你现在也能猜出
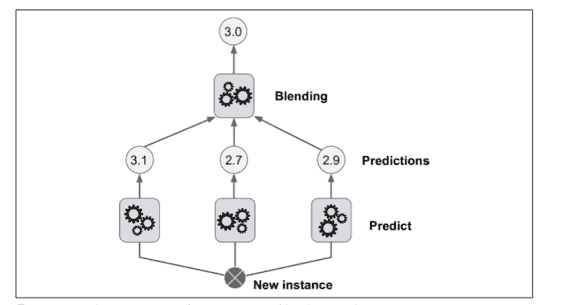
Stacking 本章讨论的最后一个集成方法叫做 Stacking ( stacked generalization 的缩写) 。 这个算法基于一个简单的想法: 不使用琐碎的函数( 如硬投票) 来聚合集合中所有分类器的预测, 我们为什么不训练一个模型来执行这个聚合? 图 7-12 展示了这样一个在新的回归实例上预测的集成。 底部三个分类器每一个都有不同的值( 3.1, 2.7 和 2.9) , 然后最后一个分类器( 叫做 blender 或者_元学习器_) 把这三个分类器的结果当做输入然后做出最终决策( 3.0)
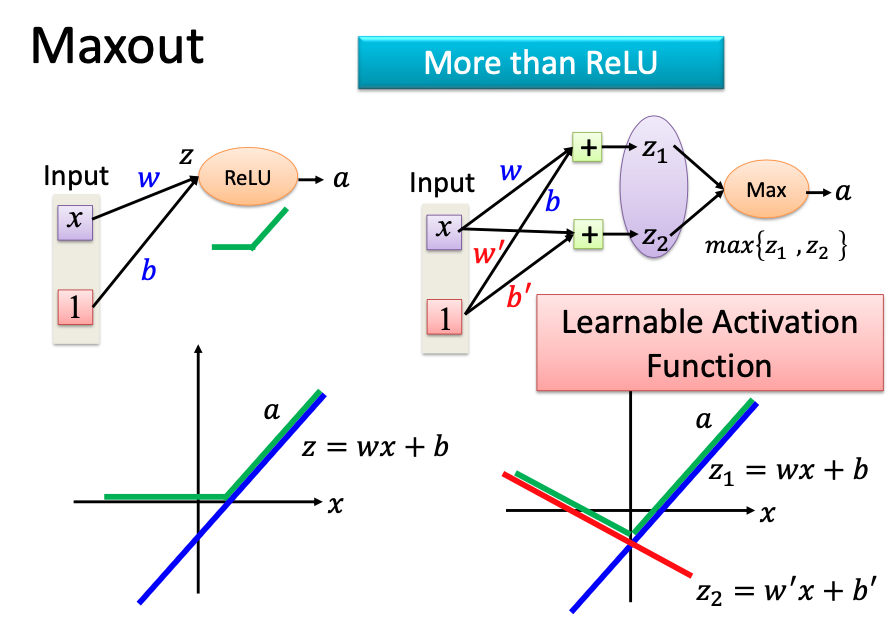
Maxout
更快的优化器
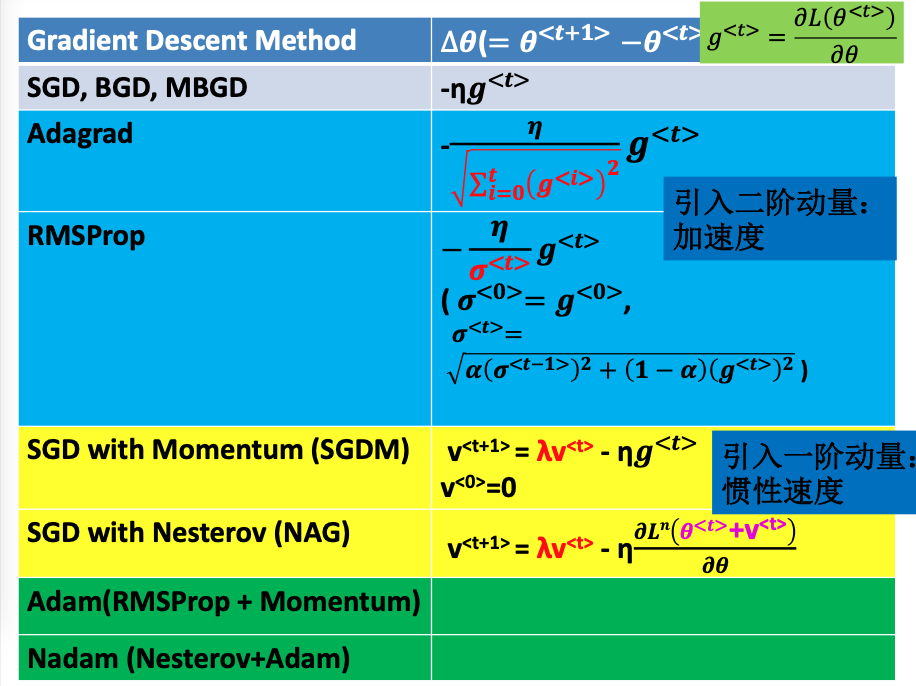
训练一个非常大的深度神经网络可能会非常缓慢。 到目前为止, 我们已经看到了四种加速训练的方法( 并且达到更好性能的方法) : 对连接权重应用良好的初始化策略, 使用良好的激活函数, 使用批归一化以及重用预训练网络的部分 ( 使用辅助任务或无监督学习) 。 另一个速度提升的方法是使用更快的优化器 , 而不是常规的梯度下降优化器。
动量优化, Nesterov 加速梯度, AdaGrad, RMSProp, 最后是 Adam 和 Nadam 优化。
回想一下, 梯度下降只是通过直接减去损失函数J(θ)相对于权重θ的梯度( ∇θJ(θ)) , 乘以学习率η来更新权重θ。 等式是: θ ← θ – η ∇[θ]J(θ)。 它不关心早期的梯度是什么。 如果局部梯度很小, 则会非常缓慢。
动量优化很关心以前的梯度: 在每次迭代时, 它将动量向量m( 乘以学习率η) 与局部梯度相加, 并且通过简单地减去该动量向量来更新权重( 参见公式 11-4) 。 换句话说, 梯度用作加速度, 不用作速度。 为了模拟某种摩擦机制, 避免动量过大, 该算法引入了一个新的超参数β, 简称为动量, 它必须设置在 0( 高摩擦) 和 1( 无摩擦) 之间。 典型的动量值是 0.9。
可以很容易验证, 如果梯度保持不变, 则最终速度( 即, 权重更新的最大大小) 等于该梯度乘以学习率η乘以1/(1-β)。 例如, 如果β = 0.9, 则最终速度等于学习率的梯度乘以 10 倍, 因此动量优化比梯度下降快 10 倍! 这使动量优化比梯度下降快得多。 特别是, 我们在第四章中看到, 当输入量具有非常不同的尺度时, 损失函数看起来像一个细长的碗( 见图 4-7) 。 梯度下降速度很快, 但要花很长的时间才能到达底部。 相反, 动量优化会越来越快地滚下山谷底部, 直到达到底部( 最佳) 。 在不使用批归一化的深度神经网络中, 较高层往往会得到具有不同的尺度的输入, 所以使用动量优化会有很大的帮助 。 它也可以帮助滚过局部最优值。
Yurii Nesterov 在 1983 年提出的动量优化的一个小变体几乎总是比普通的动量优化更快。 Nesterov 动量优化或 Nesterov 加速梯度( Nesterov Accelerated Gradient, NAG) 的思想是测量损失函数的梯度不是在局部位置, 而是在动量方向稍微靠前( 见公式 11-5) 。 与普通的动量优化的唯一区别在于梯度是在θ+βm而不是在θ处测量的。
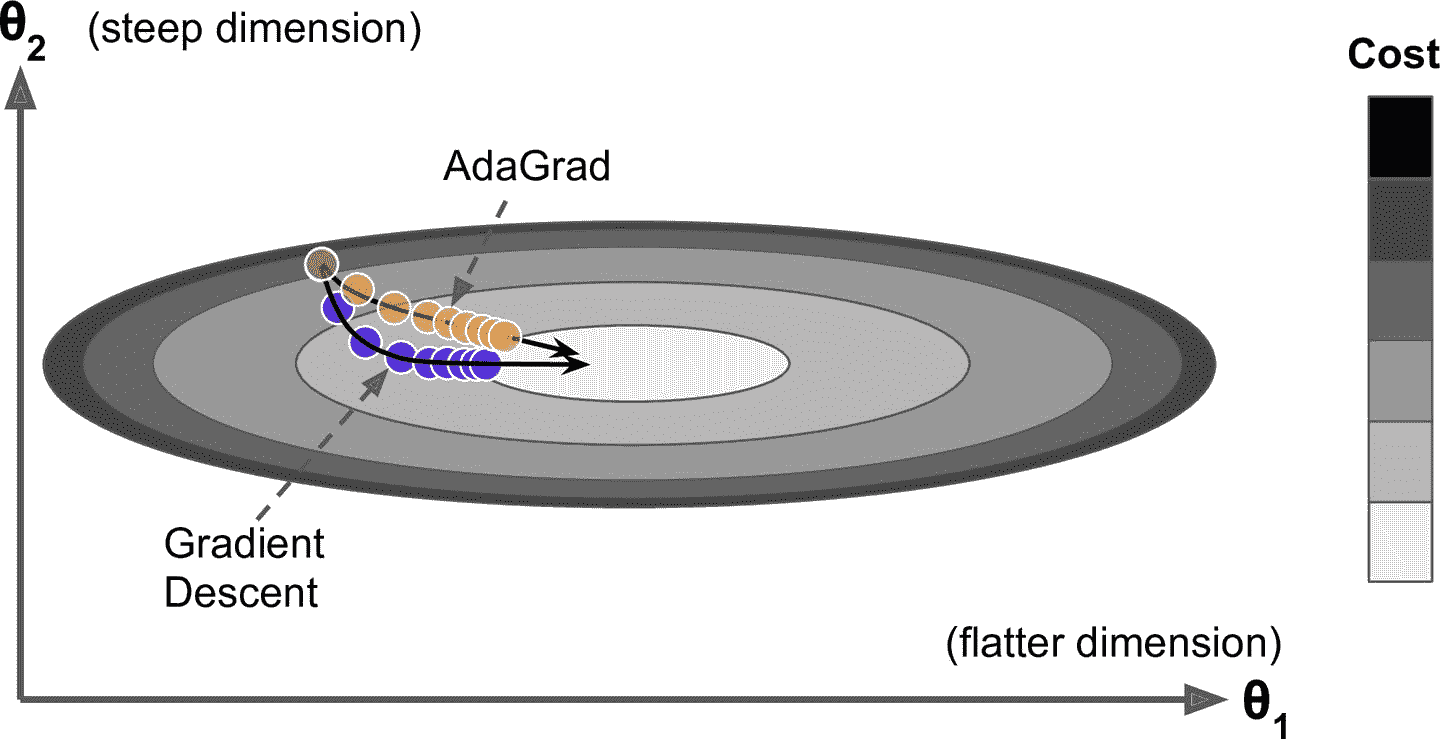
再次考虑细长碗的问题: 梯度下降从最陡峭的斜坡快速下降, 然后缓慢地下到谷底。 如果算法能够早期检测到这个问题并且纠正它的方向来指向全局最优点, 那将是非常好的。 AdaGrad 算法通过沿着最陡的维度缩小梯度向量来实现这一点( 见公式 11-6) :
第一步将梯度的平方累加到向量s中( ⊗符号表示元素级别相乘) 。 这个向量化形式相当于向量s的每个元素s[i]计算s[i] ← s[i] + (∂J(θ)/∂θ[i])^2。 换一种说法, 每个s[i]累加损失函数对参数θ[i]的偏导数的平方。 如果损失函数沿着第i维陡峭, 则在每次迭代时, s[i]将变得越来越大。
第二步几乎与梯度下降相同, 但有一个很大的不同: 梯度向量按比例(s+ε)^0.5缩小 ( ⊘符号表示元素分割, ε是避免被零除的平滑项, 通常设置为10^(-10)。 这个向量化的形式相当于所有θ[i]同时计算
前面看到, AdaGrad 的风险是降速太快, 可能无法收敛到全局最优。 RMSProp 算法通过仅累积最近迭代( 而不是从训练开始以来的所有梯度) 的梯度来修正这个问题。 它通过在第一步中使用指数衰减来实现( 见公式 11-7) 。
如果你只看步骤 1, 2 和 5, 你会注意到 Adam 与动量优化和 RMSProp 的相似性。 唯一的区别是第 1 步计算指数衰减的平均值, 而不是指数衰减的和, 但除了一个常数因子( 衰减平均值只是衰减和的1 - β1倍) 之外, 它们实际上是等效的。 动量衰减超参数β1通常初始化为 0.9, 而缩放衰减超参数β2通常初始化为 0.999。 如前所述, 平滑项ε通常被初始化为一个很小的数, 例如10^(-7)。
实际上, 由于 Adam 是一种自适应学习率算法( 如 AdaGrad 和 RMSProp) , 所以对学习率超参数η的调整较少。 您经常可以使用默认值η= 0.001, 使 Adam 相对于梯度下降更容易使用。
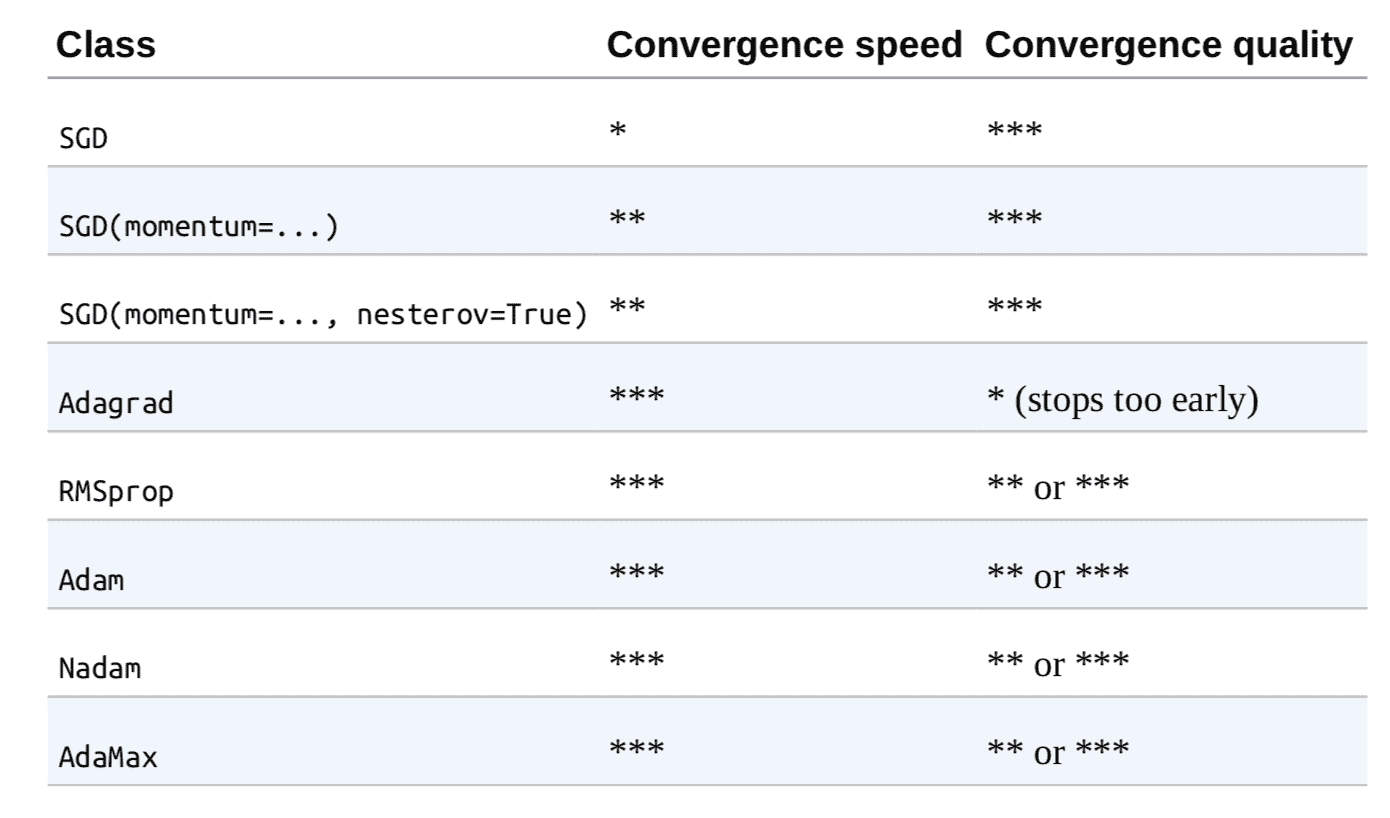
表 11-2 比较了讨论过的优化器( *是差, **是平均, ***是好) 。
正则化Regularization 有四个参数, 我可以拟合一个大象, 五个我可以让他摆动他的象鼻。 —— John von Neumann,cited by Enrico Fermi in Nature 427
有数千个参数, 甚至可以拟合整个动物园。 深度神经网络通常具有数以万计的参数, 有时甚至是数百万。 有了这么多的参数, 网络拥有难以置信的自由度, 可以适应各种复杂的数据集。 但是这个很大的灵活性也意味着它很容易过拟合训练集。 所以需要正则。 第 10 章用过了最好的正则方法之一: 早停。 _EarlyStopping
这一节会介绍其它一些最流行的神经网络正则化技术: ℓ1 和 ℓ2 正则、 丢弃和最大范数正则。
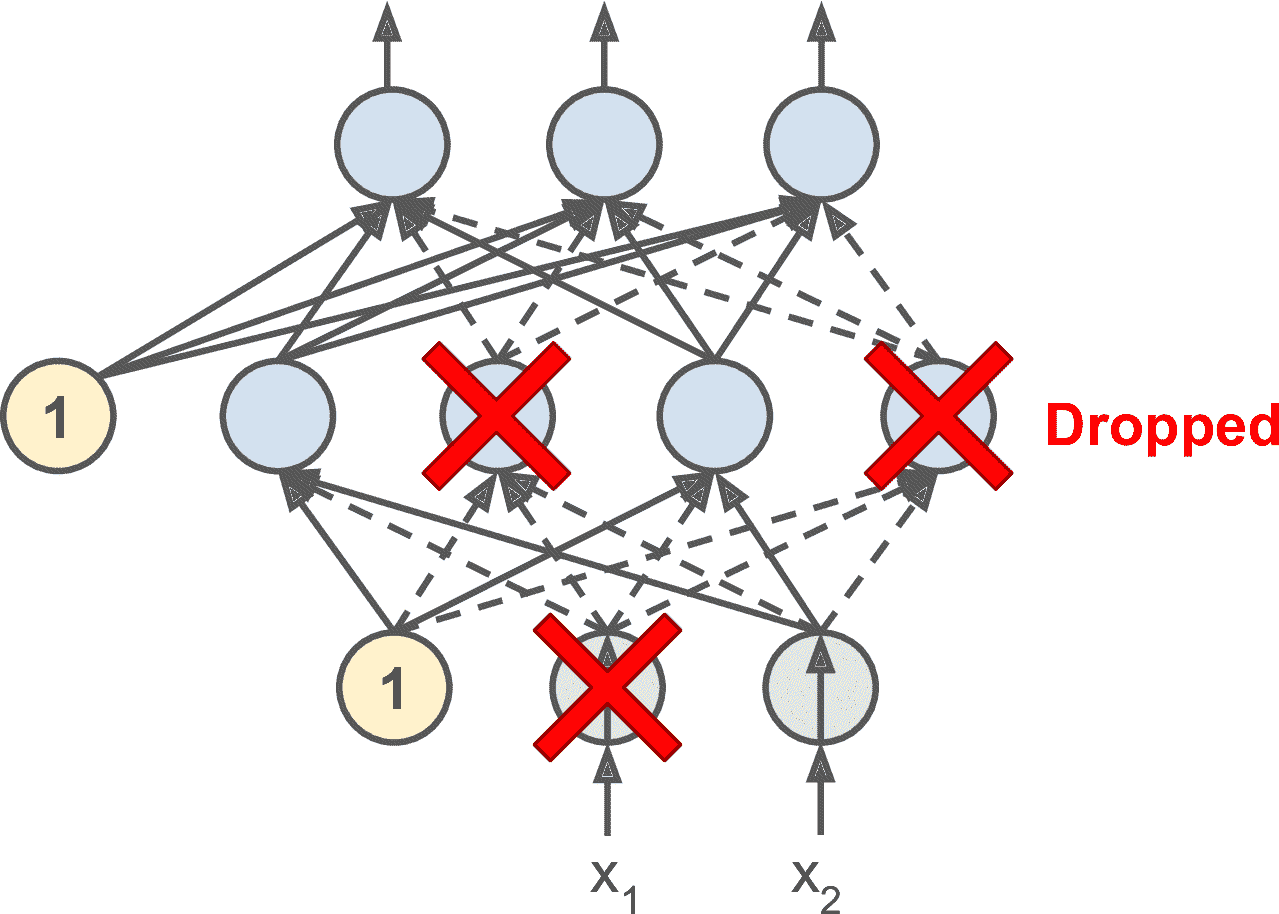
Dropout 丢弃是深度神经网络最流行的正则化方法之一。 它由 Geoffrey Hinton 于 2012 年提出, 并在 Nitish Srivastava 等人的 2014 年论文中进一步详细描述, 并且已被证明是非常成功的: 即使是最先进的神经网络, 仅仅通过增加丢弃就可以提高 1-2% 的准确度。
这是一个相当简单的算法: 在每个训练步骤中, 每个神经元( 包括输入神经元, 但不包括输出神经元) 都有一个暂时“ 丢弃” 的概率p, 这意味着在这个训练步骤中它将被完全忽略, 在下一步可能会激活( 见图 11-9) 。 超参数p称为丢弃率, 通常设为 10% 到 50% 之间; 循环神经网络之间接近 20-30%, 在卷积网络中接近 40-50%。 训练后, 神经元不会再丢失。
这个具有破坏性的方法竟然行得通, 这是相当令人惊讶的。 如果一个公司的员工每天早上被告知要掷硬币来决定是否上班, 公司的表现会不会更好呢? 那么, 谁知道; 也许会! 公司显然将被迫适应这样的组织构架; 它不能依靠任何一个人操作咖啡机或执行任何其他关键任务, 所以这个专业知识将不得不分散在几个人身上。 员工必须学会与其他的许多同事合作, 而不仅仅是其中的一小部分。 该公司将变得更有弹性。 如果一个人离开了, 并没有什么区别。 目前还不清楚这个想法是否真的可以在公司实行, 但它确实对于神经网络是可行的。 神经元被丢弃训练不能与其相邻的神经元共适应; 他们必须尽可能让自己变得有用。 他们也不能过分依赖一些输入神经元;他们必须注意他们的每个输入神经元。 他们最终对输入的微小变化会不太敏感。 最后, 你会得到一个更稳定的网络, 泛化能力更强。
CNN-CV 卷积神经网络( CNN) 起源于人们对大脑视神经的研究, 自从 1980 年代, CNN 就被用于图像识别了。 最近几年, 得益于算力提高、 训练数据大增, 以及第 11 章中介绍过的训练深度网络的技巧, CNN 在一些非常复杂的视觉任务上取得了超出人类表现的进步。 CNN 支撑了图片搜索、 无人驾驶汽车、 自动视频分类, 等等。 另外, CNN 也不再限于视觉, 比如: 语音识别和自然语言处理, 但这一章只介绍视觉应用。
David H. Hubel 和 Torsten Wiesel 在 1958 年和 1959 年在猫的身上做了一系列研究, 对视神经中枢做了研究( 并在 1981 年荣获了诺贝尔生理学或医学奖) 。 特别的, 他们指出视神经中的许多神经元都有一个局部感受域( local receptive field) , 也就是说, 这些神经元只对有限视觉区域的刺激作反应
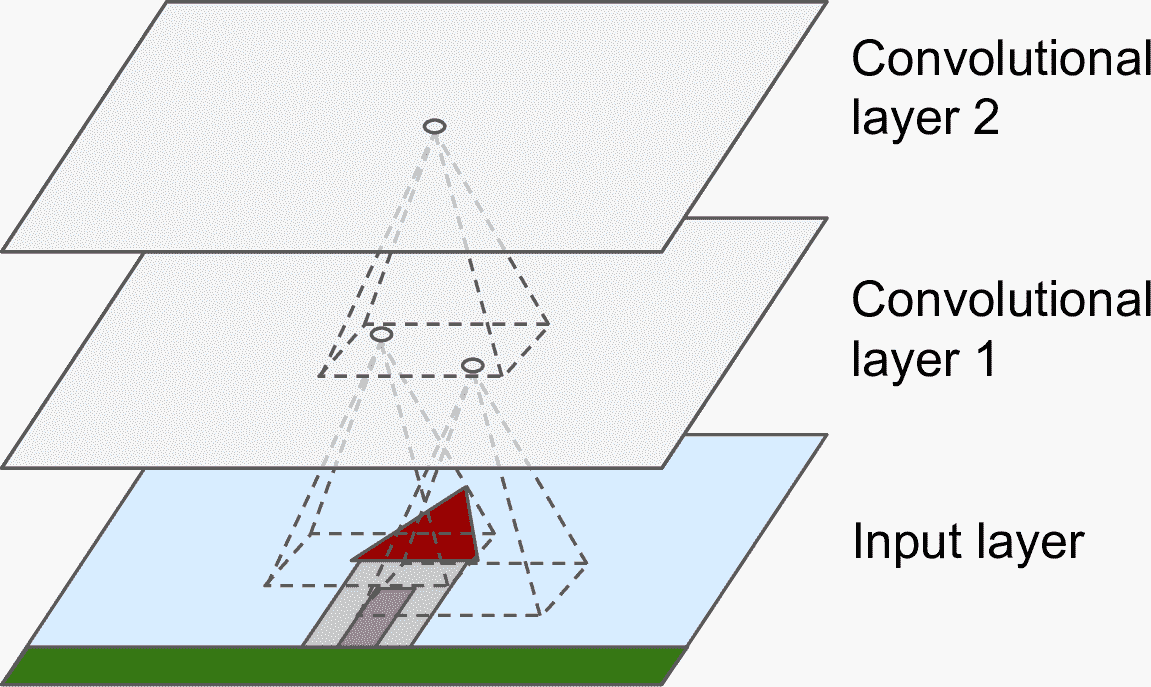
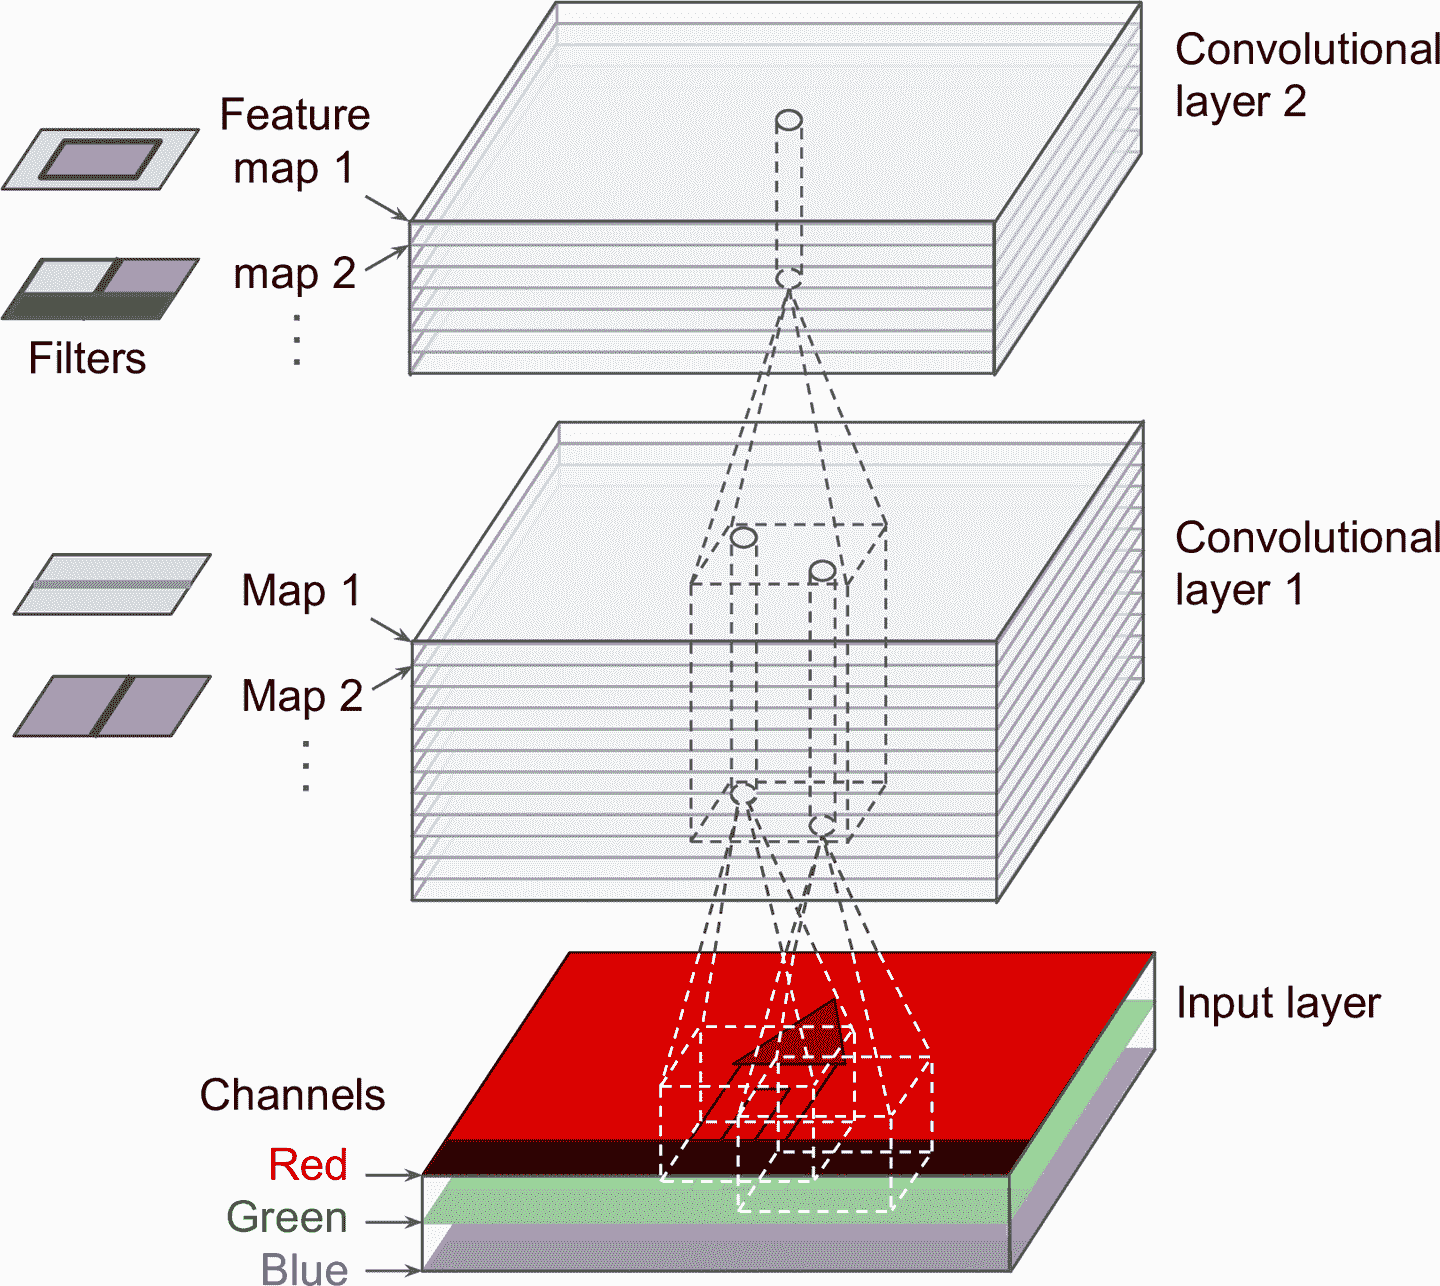
卷积层ConvalutionalLayer 卷积层是 CNN 最重要的组成部分: 第一个卷积层的神经元, 不是与图片中的每个像素点都连接, 而是只连着局部感受野的像素( 见图 14-2) 。 同理, 第二个卷积层中的每个神经元也只是连着第一层中一个小方形内的神经元。 这种架构可以让第一个隐藏层聚焦于小的低级特征, 然后在下一层组成大而高级的特征
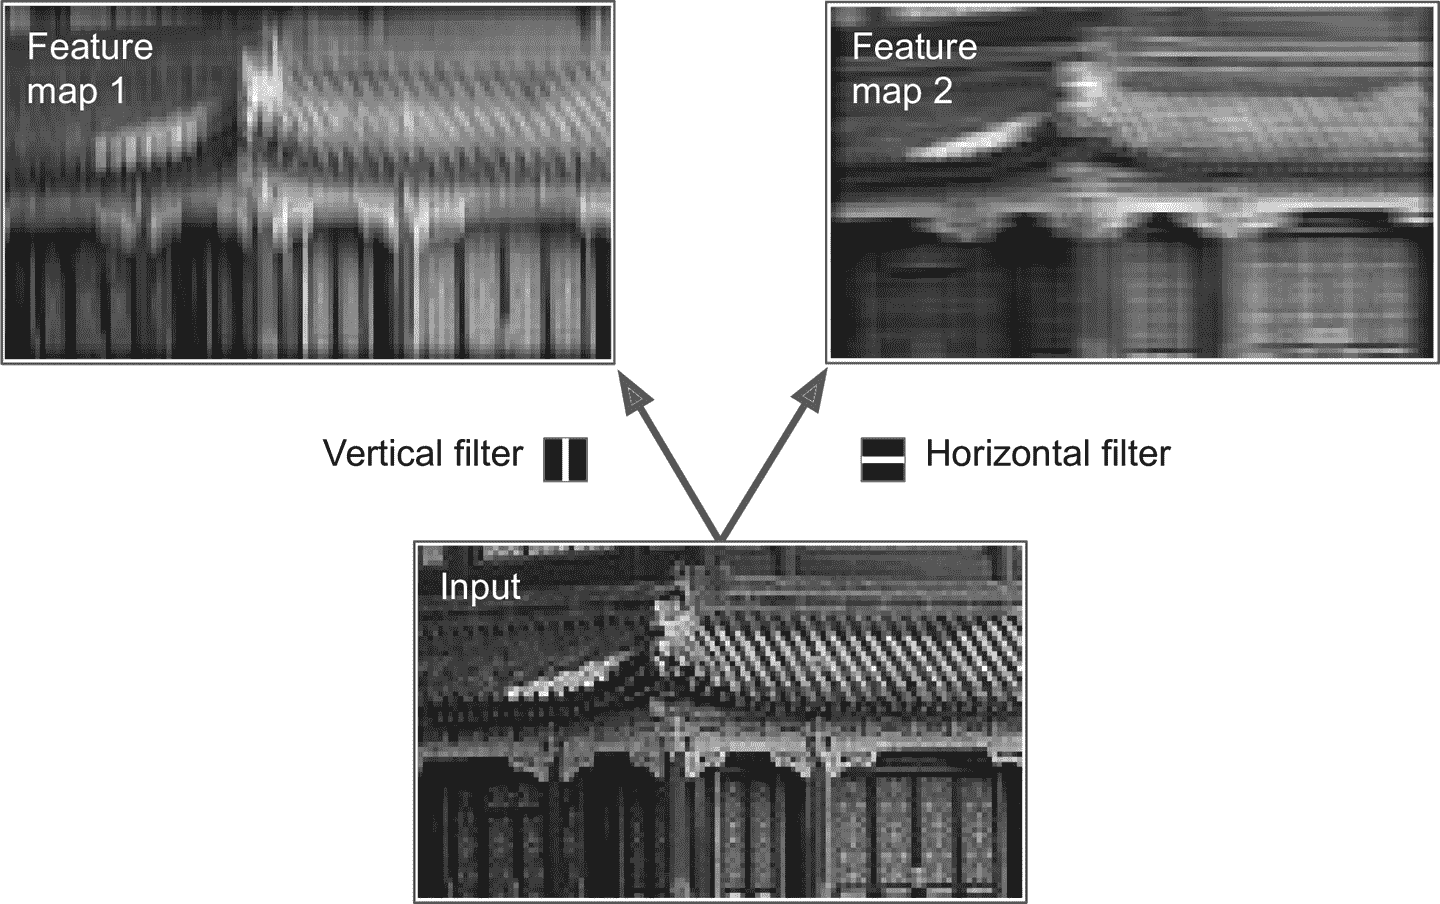
神经元的权重可以表示为感受野大小的图片。 例如, 图 14-5 展示了两套可能的权重( 称为权重, 或卷积核) 。 第一个是黑色的方形, 中央有垂直白线( 7 × 7的矩阵, 除了中间的竖线都是 1, 其它地方是 0) ; 使用这个矩阵, 神经元只能注意到中间的垂直线( 因为其它地方都乘以 0 了) 。 第二个过滤器也是黑色的方形, 但是中间是水平的白线。 使用这个权重的神经元只会注意中间的白色水平线。
如果卷积层的所有神经元使用同样的垂直过滤器( 和同样的偏置项) , 给神经网络输入图 14-5 中最底下的图片, 卷积层输出的是左上的图片。 可以看到, 图中垂直的白线得到了加强, 其余部分变模糊了。 相似的, 右上的图是所有神经元都是用水平线过滤器的结果, 水平的白线加强了, 其余模糊了。 因此, 一层的全部神经元都用一个过滤器, 就能输出一个特征映射( feature map) , 特征映射可以高亮图片中最为激活过滤器的区域。 当然, 不用手动定义过滤器: 卷积层在训练中可以自动学习对任务最有用的过滤器, 上面的层则可以将简单图案组合为复杂图案。
简单起见, 前面都是将每个卷积层的输出用 2D 层来表示的, 但真实的卷积层可能有多个过滤器( 过滤器数量由你确定) , 每个过滤器会输出一个特征映射, 所以表示成 3D 更准确
下面代码使用 Scikit-Learn 的`load_sample_image()`加载了两张图片, 一张是中国的寺庙, 另一张是花, 创建了两个过滤器, 应用到了两张图片上, 最后展示了一张特征映射: from sklearn.datasets import load_sample_imagechina = load_sample_image("china.jpg" ) / 255 flower = load_sample_image("flower.jpg" ) / 255 /images = np.array([china, flower]) batch_size, height, width, channels = /images.shape filters = np.zeros(shape=(7 , 7 , channels, 2 ), dtype=np.float32) filters[:, 3 , :, 0 ] = 1 filters[3 , :, :, 1 ] = 1 outputs = tf.nn.conv2d(/images, filters, strides=1 , padding="same" ) plt.imshow(outputs[0 , :, :, 1 ], cmap="gray" ) plt.show() 这个例子中, 我们手动定义了过滤器, 但在真正的 CNN 中, 一般将过滤器定义为可以训练的变量, 好让神经网络学习哪个过滤器的效果最好。 使用`keras.layers.Conv2D`层: conv = keras.layers.Conv2D(filters=32 , kernel_size=3 , strides=1 , padding="same" , activation="relu" )
tf.nn.conv2d()函数这一行, 再多说说:
/images是一个输入的小批次( 4D 张量) 。
filters是过滤器的集合( 也是 4D 张量) 。
strides等于 1, 也可以是包含 4 个元素的 1D 数组, 中间的两个元素是垂直和水平步长( s[h]和s[w]) , 第一个和最后一个元素现在必须是 1。 以后可以用来指定批次步长( 跳过实例) 和通道步长( 跳过前一层的特征映射或通道) 。
padding必须是"same"或"valid":
如果设为"same", 卷积层会使用零填充。 输出的大小是输入神经元的数量除以步长, 再取整。 例如: 如果输入大小是 13, 步长是 5( 见图 14-7) , 则输出大小是 3( 13 / 5 = 2.6, 再向上圆整为 3) , 零填充尽量在输入上平均添加。 当strides=1时, 层的输出会和输入有相同的空间维度( 宽和高) , 这就是same的来历。
如果设为"valid", 卷积层就不使用零填充, 取决于步长, 可能会忽略图片的输入图片的底部或右侧的行和列, 见图 14-7( 简单举例, 只是显示了水平维度) 。 这意味着每个神经元的感受野位于严格确定的图片中的位置( 不会越界) , 这就是valid的来历。
CNN 的另一个问题是卷积层需要很高的内存。 特别是在训练时, 因为反向传播需要所有前向传播的中间值。
池化层 明白卷积层的原理了, 池化层就容易多了。 池化层的目的是对输入图片做降采样( 即, 收缩) , 以降低计算负载、 内存消耗和参数的数量( 降低过拟合) 。
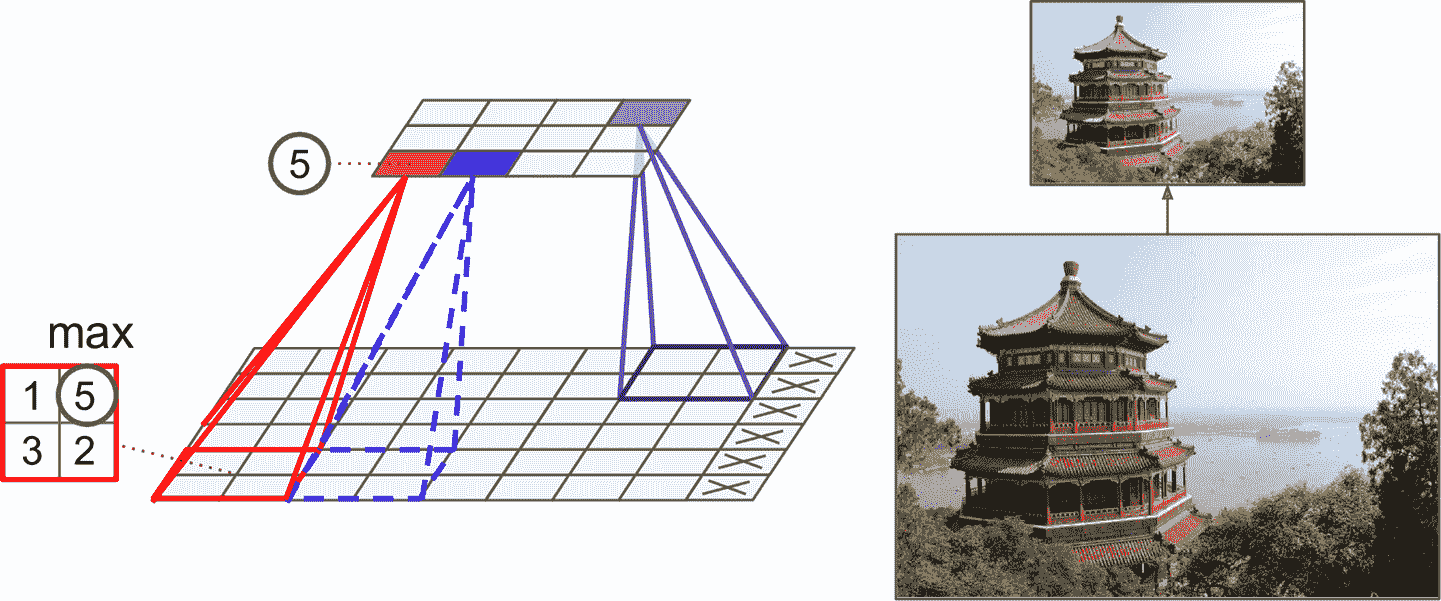
和卷积层一样, 池化层中的每个神经元也是之和前一层的感受野里的有限个神经元相连。 和前面一样, 必须定义感受野的大小、 步长和填充类型。 但是, 池化神经元没有权重, 它所要做的是使用聚合函数, 比如最大或平均, 对输入做聚合。 图 14-8 展示了最为常用的最大池化层。 在这个例子中, 使用了一个2 × 2的池化核, 步长为 2, 没有填充。 只有感受野中的最大值才能进入下一层, 其它的就丢弃了。
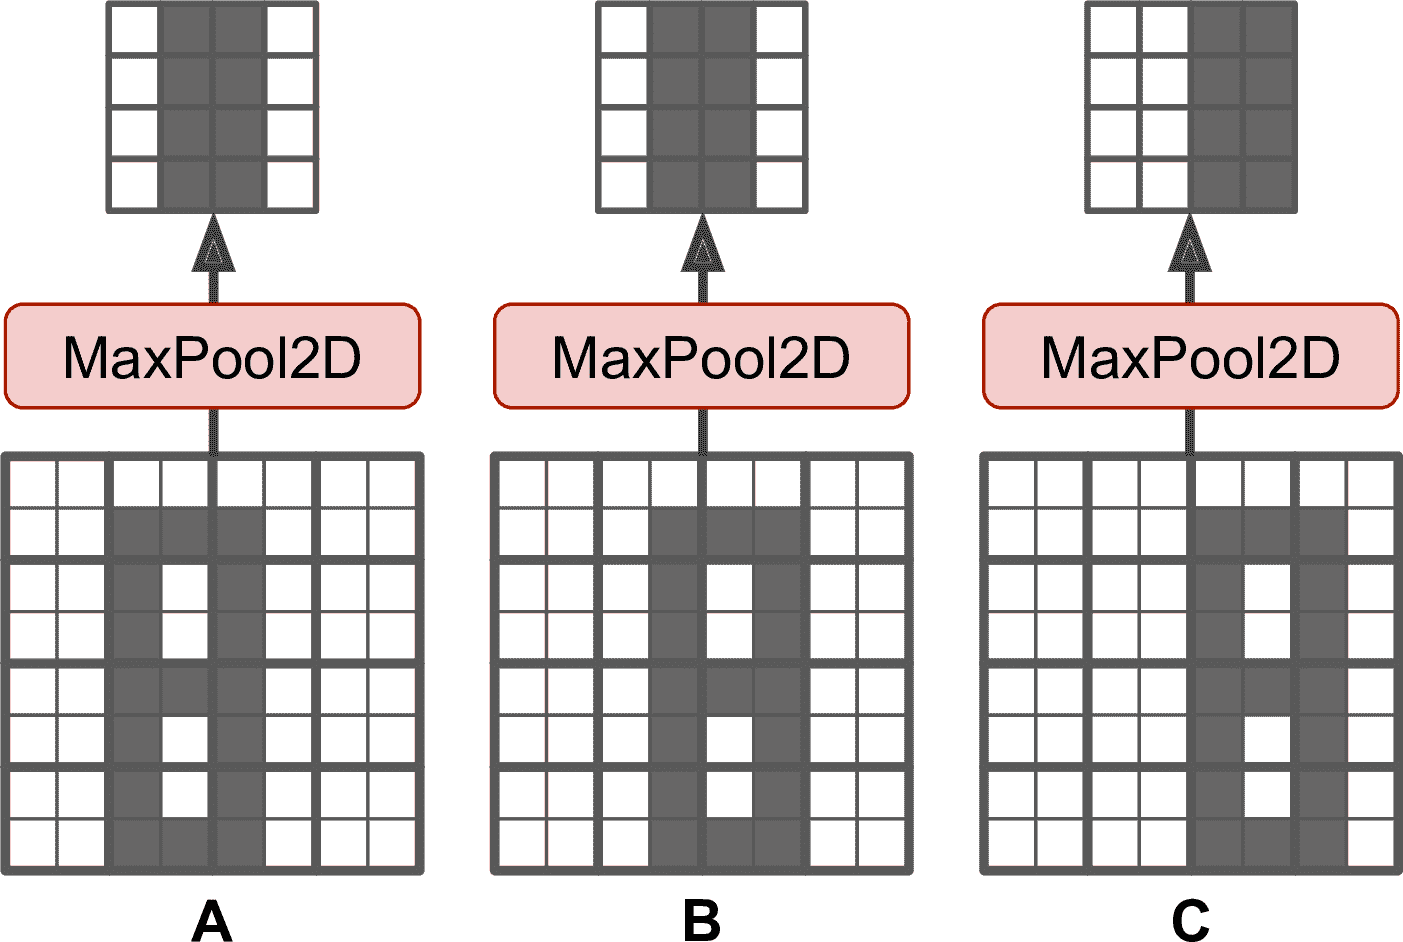
除了可以减少计算、 内存消耗、 参数数量, 最大池化层还可以带来对小偏移的不变性
在 CNN 中每隔几层就插入一个最大池化层, 可以带来更大程度的平移不变性。 另外, 最大池化层还能带来一定程度的旋转不变性和缩放不变性。 当预测不需要考虑平移、 旋转和缩放时, 比如分类任务, 不变性可以有一定益处。
要创建平均池化层, 则使用AvgPool2D。 平均池化层和最大池化层很相似, 但计算的是感受野的平均值。 平均池化层在过去很流行, 但最近人们使用最大池化层更多, 因为最大池化层的效果更好。
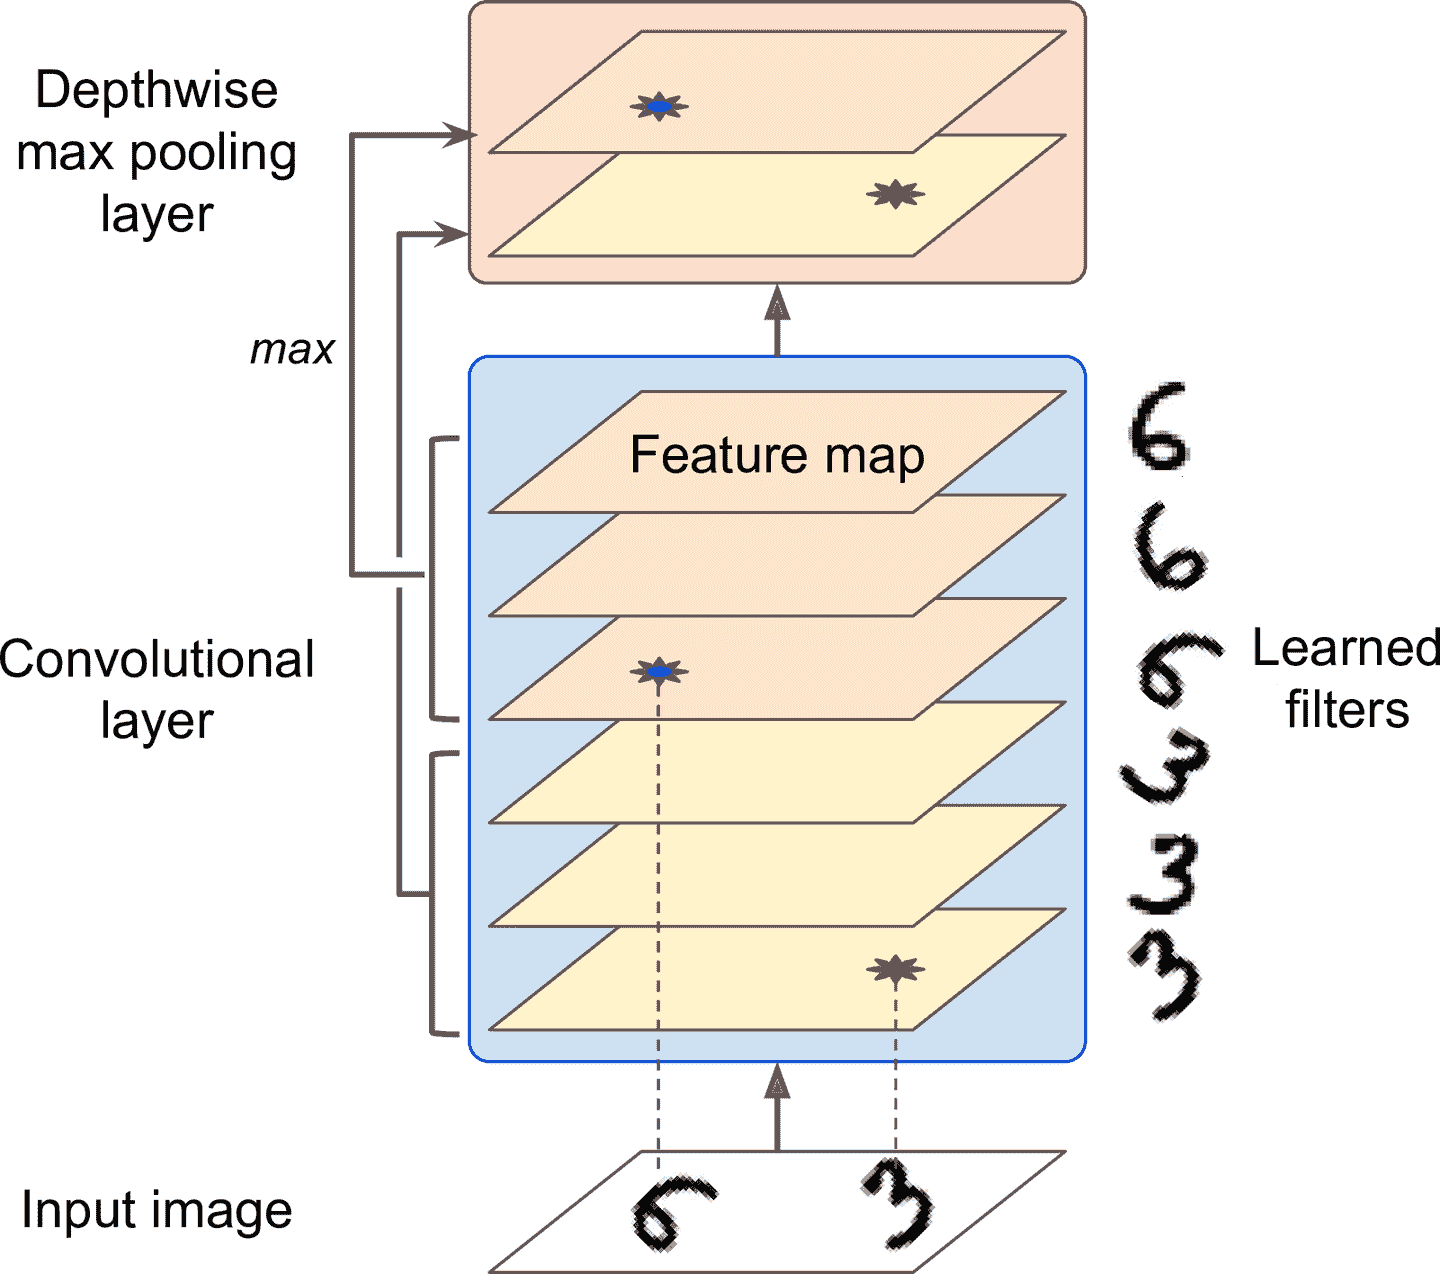
池化层还可以沿着深度方向做计算。 这可以让 CNN 学习到不同特征的不变性。 比如。 CNN 可以学习多个过滤器, 每个过滤器检测一个相同的图案的不同旋转( 比如手写字, 见图 14-10) , 深度池化层可以使输出相同。 CNN 还能学习其它的不变性: 厚度、 明亮度、 扭曲、 颜色, 等等。
数据增强 数据增强是通过生成许多训练实例的真实变种, 来人为增大训练集。 因为可以降低过拟合, 成为了一种正则化方法。 生成出来的实例越真实越好: 最理想的情况, 人们无法区分增强图片是原生的还是增强过的。 简单的添加白噪声没有用, 增强修改要是可以学习的( 白噪声不可学习) 。
例如, ==可以轻微偏移、 旋转、 缩放原生图, 再添加到训练集中==( 见图 14-12) 。 这么做可以使模型对位置、 方向和物体在图中的大小, 有更高的容忍度。 如果想让模型对不同光度有容忍度, 可以生成对比度不同的照片。 通常, ==还可以水平翻转图片( 文字不成、 不对称物体也不成) ==。 通过这些变换, 可以极大的增大训练集。
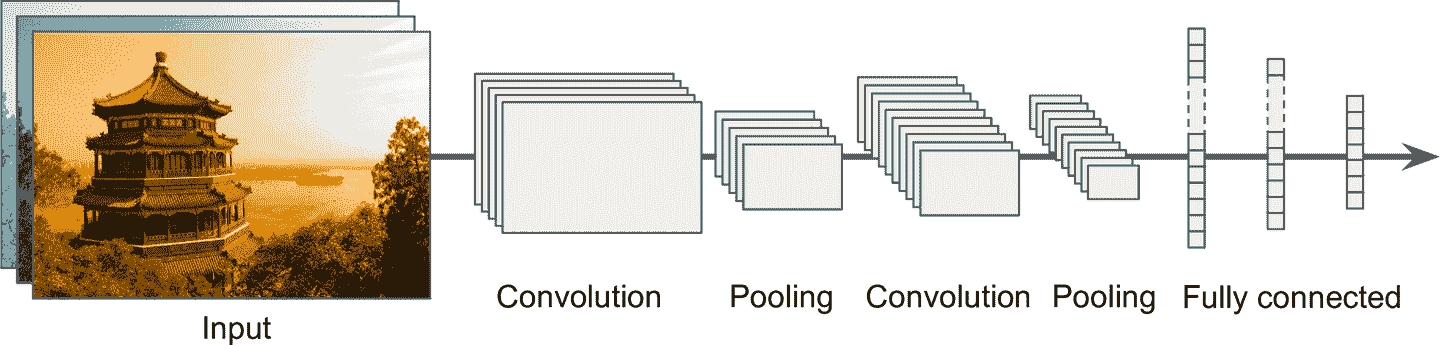
CNN的典型架构 CNN 的典型架构是将几个卷积层叠起来( 每个卷积层后面跟着一个 ReLU 层) , 然后再叠一个池化层, 然后再叠几个卷积层( +ReLU) , 接着再一个池化层, 以此类推。 图片在流经神经网络的过程中, 变得越来越小, 但得益于卷积层, 却变得越来越深( 特征映射变多了) , 见图 14-11。 在 CNN 的顶部, 还有一个常规的前馈神经网络, 由几个全连接层( +ReLU) 组成, 最终层输出预测( 比如, 一个输出类型概率的 softmax 层) 。
model = keras.models.Sequential([ keras.layers.Conv2D(64 , 7 , activation="relu" , padding="same" , input_shape=[28 , 28 , 1 ]), keras.layers.MaxPooling2D(2 ), keras.layers.Conv2D(128 , 3 , activation="relu" , padding="same" ), keras.layers.Conv2D(128 , 3 , activation="relu" , padding="same" ), keras.layers.MaxPooling2D(2 ), keras.layers.Conv2D(256 , 3 , activation="relu" , padding="same" ), keras.layers.Conv2D(256 , 3 , activation="relu" , padding="same" ), keras.layers.MaxPooling2D(2 ), keras.layers.Flatten(), keras.layers.Dense(128 , activation="relu" ), keras.layers.Dropout(0.5 ), keras.layers.Dense(64 , activation="relu" ), keras.layers.Dropout(0.5 ), keras.layers.Dense(10 , activation="softmax" ) ])
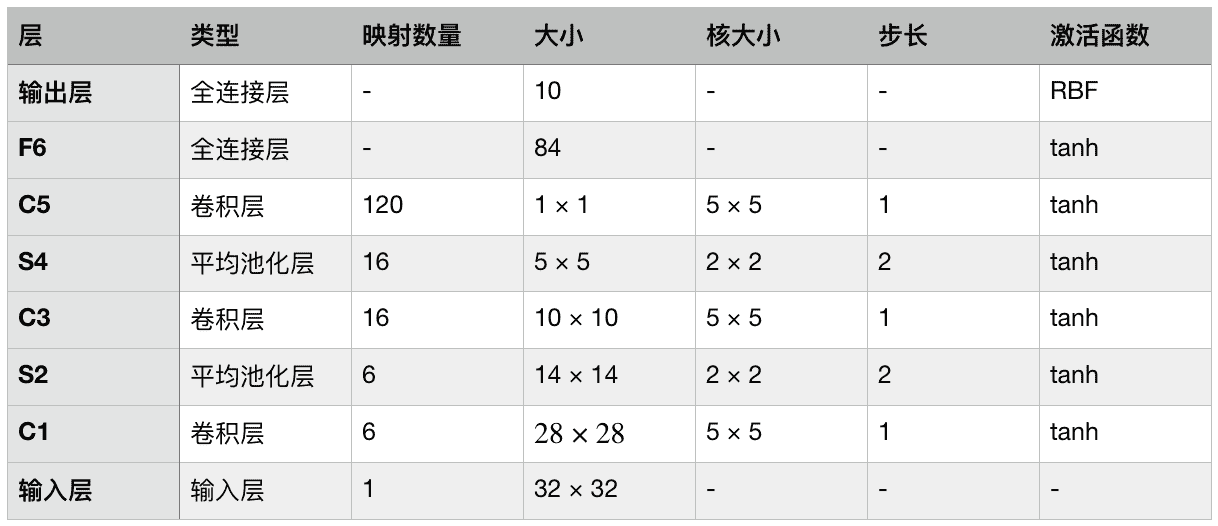
我们先看看经典的 LeNet-5 架构( 1998) , 然后看看三个 ILSVRC 竞赛的冠军: AlexNet( 2012) 、 GoogLeNet( 2014) 、 ResNet( 2015) 。
LeNet-5 也许是最广为人知的 CNN 架构。 前面提到过, 它是由 Yann LeCun 在 1998 年创造出来的, 被广泛用于手写字识别( MNIST) 。 它的结构如下:
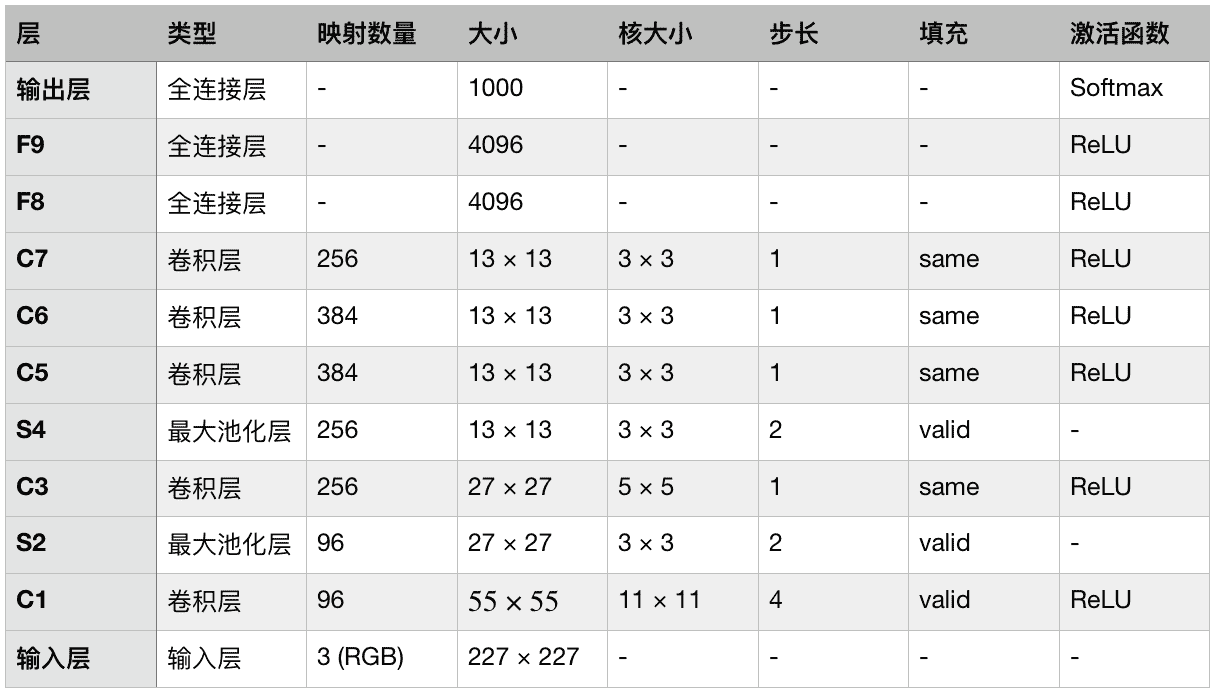
AlexNet 和 LeNet-5 很相似, 只是更大更深, 是首个将卷积层堆叠起来的网络, 而不是在每个卷积层上再加一个池化层。 为了降低过拟合, 作者使用了两种正则方法。 首先, F8 和 F9 层使用了丢弃, 丢弃率为 50%。 其次, 他们通过随机距离偏移训练图片、 水平翻转、 改变亮度, 做了数据增强。
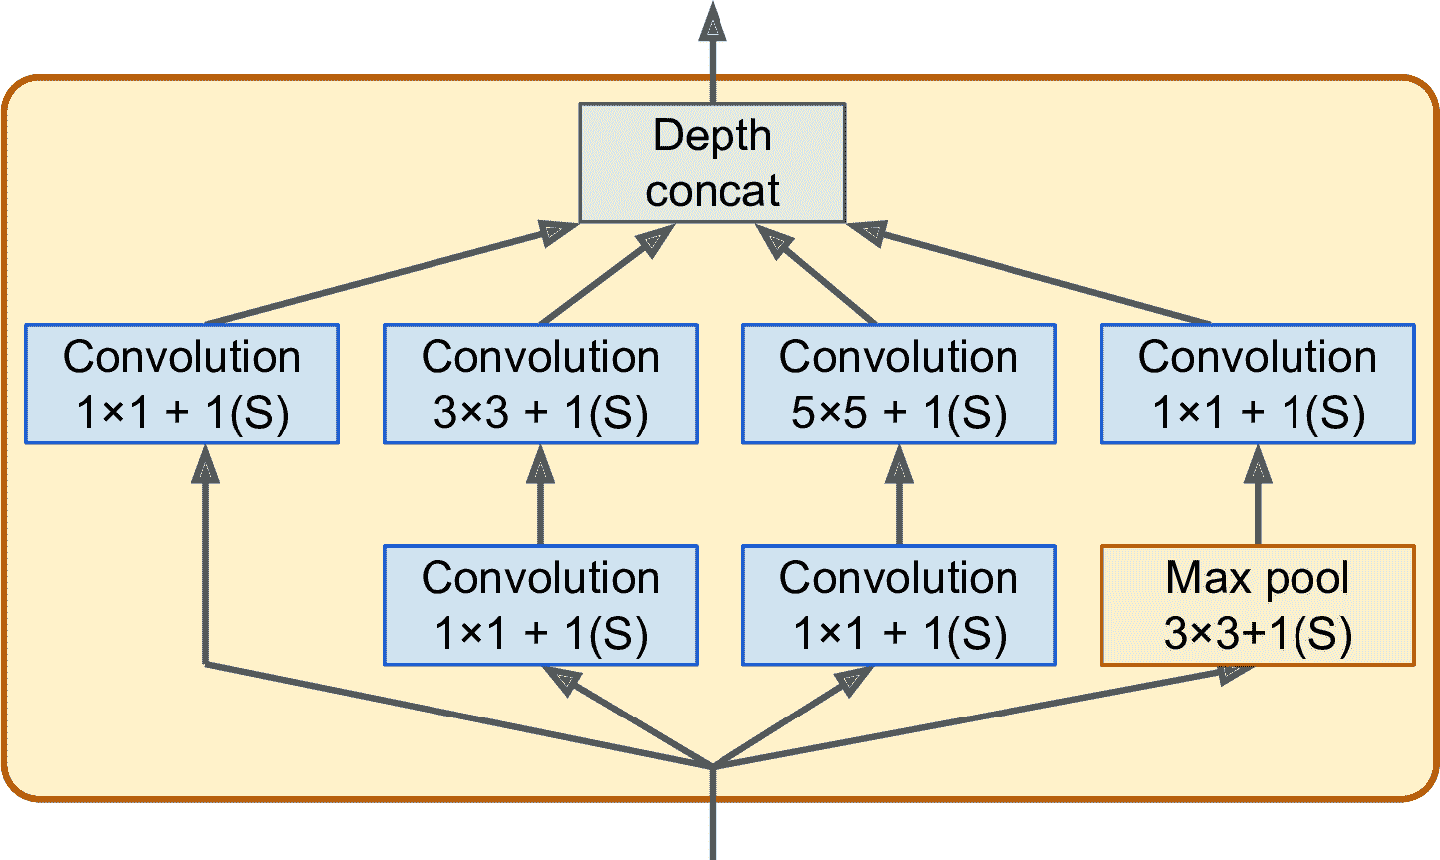
GoogLeNet 架构 能取得这么大的进步, 很大的原因是它的网络比之前的 CNN 更深( 见图 14-14) 。 这归功于被称为创始模块( inception module) 的子网络, 它可以让 GoogLeNet 可以用更高的效率使用参数
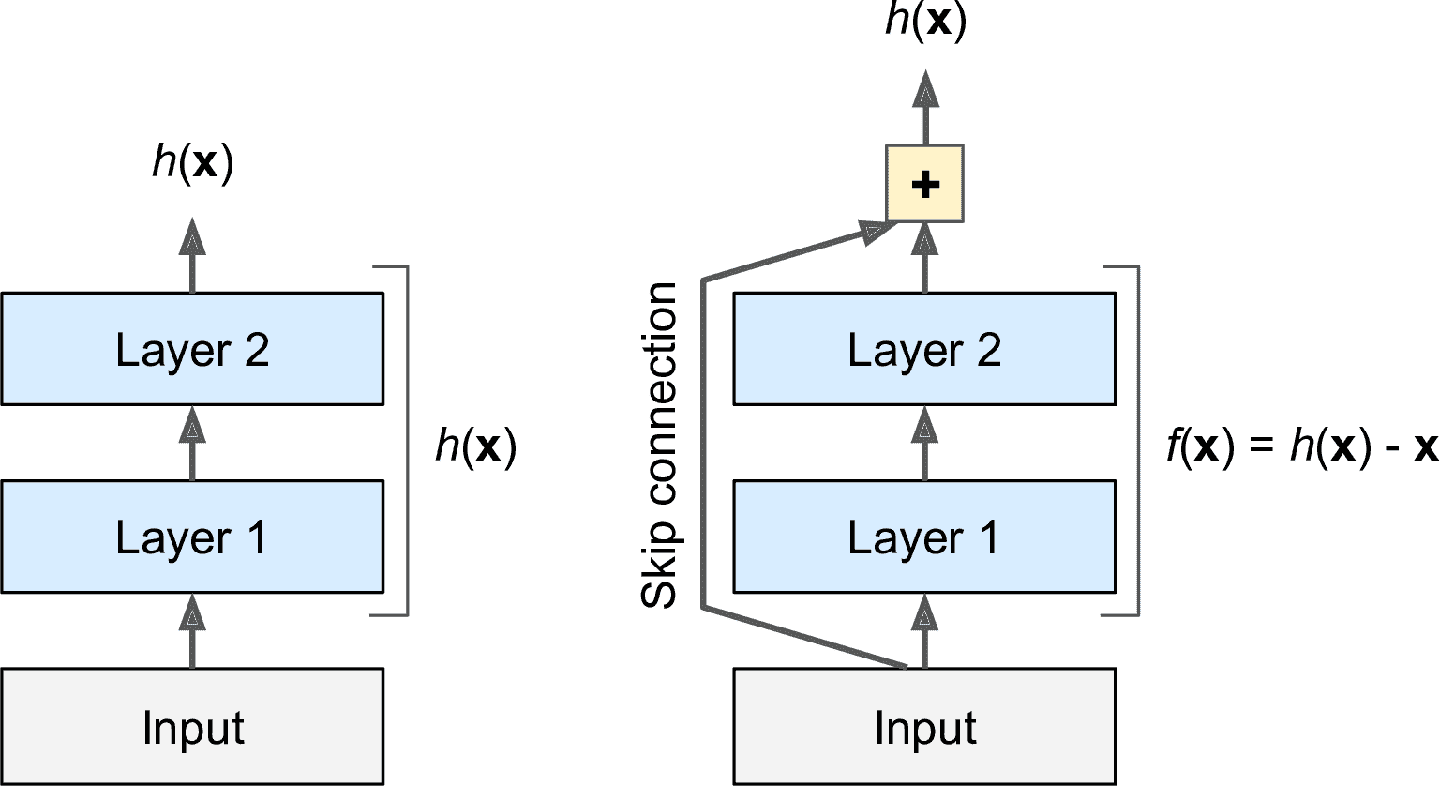
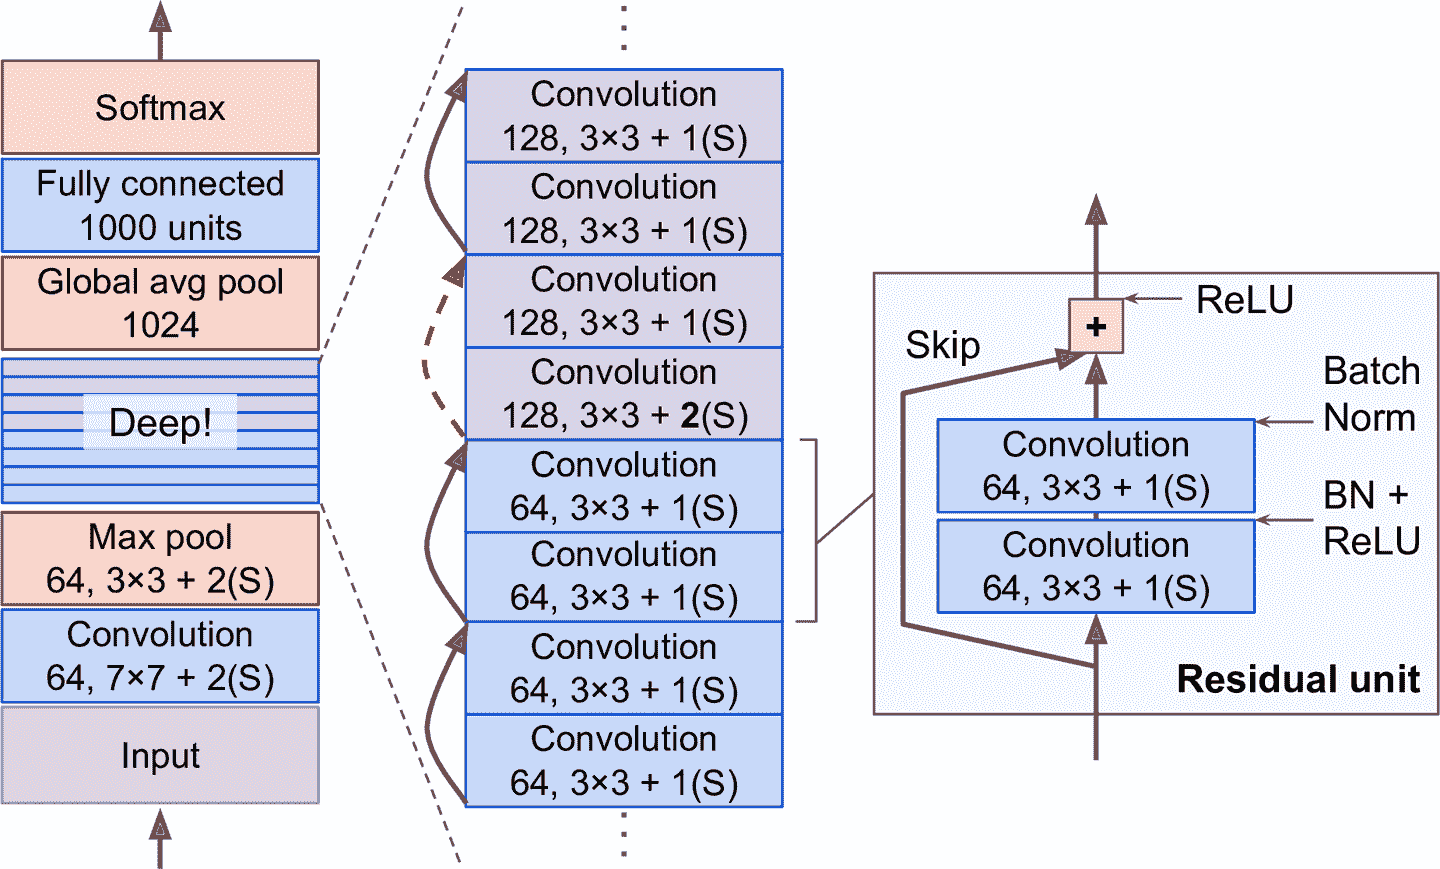
ResNet 的使用了极深的卷积网络, 共 152 层( 其它的变体有 1450 或 152 层) 。 反映了一个总体趋势: 模型变得越来越深, 参数越来越少。 训练这样的深度网络的方法是使用跳连接( 也被称为快捷连接) : 输入信号添加到更高层的输出上。
训练神经网络时, 目标是使网络可以对目标函数h(x)建模。 如果将输入x添加给网络的输出( 即, 添加一个跳连接) , 则网络就要对f(x) = h(x) – x建模, 而不是h(x)。 这被称为残差学习( 见图 14-15) 。
目标检测 分类并定位图片中的多个物体的任务被称为目标检测。 几年之前, 使用的方法还是用定位单一目标的 CNN, 然后将其在图片上滑动
用这个简单的方法来做目标检测的效果相当不错, 但需要运行 CNN 好几次, 所以很慢。 幸好, 有一个更快的方法来滑动 CNN: 使用全卷积网络( fully convolutional network, FCN) 。
YOLO 是一个非常快且准确的目标检测框架, 是 Joseph Redmon 在 2015 年的一篇论文 中提出的, 2016 年优化为 YOLOv2 , 2018 年优化为 YOLOv3 。 速度快到甚至可以在实时视频中运行
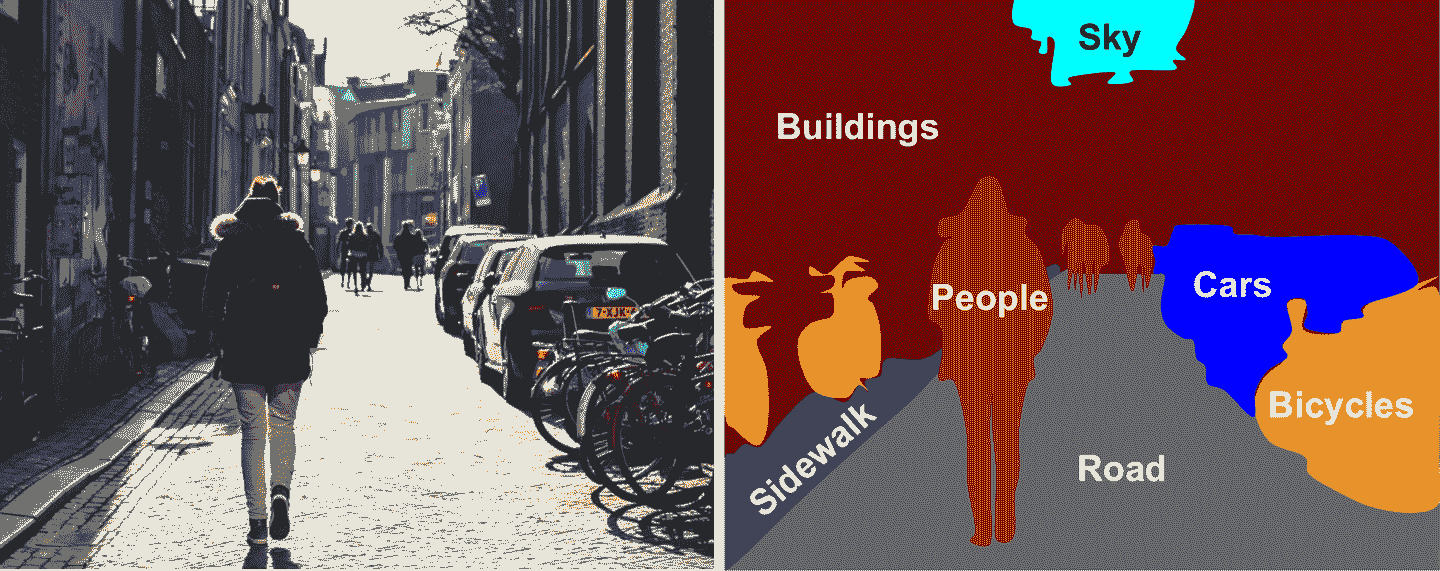
语义分割 在语义分割中, 每个像素根据其所属的目标来进行分类( 例如, 路、 汽车、 行人、 建筑物, 等等) , 见图 14-26。 注意, 相同类的不同目标是不做区分的。 例如, 分割图片的右侧的所有自行车被归类为一坨像素。 这个任务的难点是当图片经过常规 CNN 时, 会逐渐丢失空间分辨率( 因为有的层的步长大于 1) ; 因此, 常规的 CNN 可以检测出图片的左下有一个人, 但不知道准确的位置。
RNN RNN 不是唯一能处理序列数据的神经网络: 对于小序列, 常规紧密网络也可以; 对于长序列, 比如音频或文本, 卷积神经网络也可以。 我们会讨论这两种方法, 本章最后会实现一个 WaveNet: 这是一种 CNN 架构, 可以处理上万个时间步的序列。 在第 16 章, 还会继续学习 RNN, 如何使用 RNN 来做自然语言处理, 和基于注意力机制的新架构。
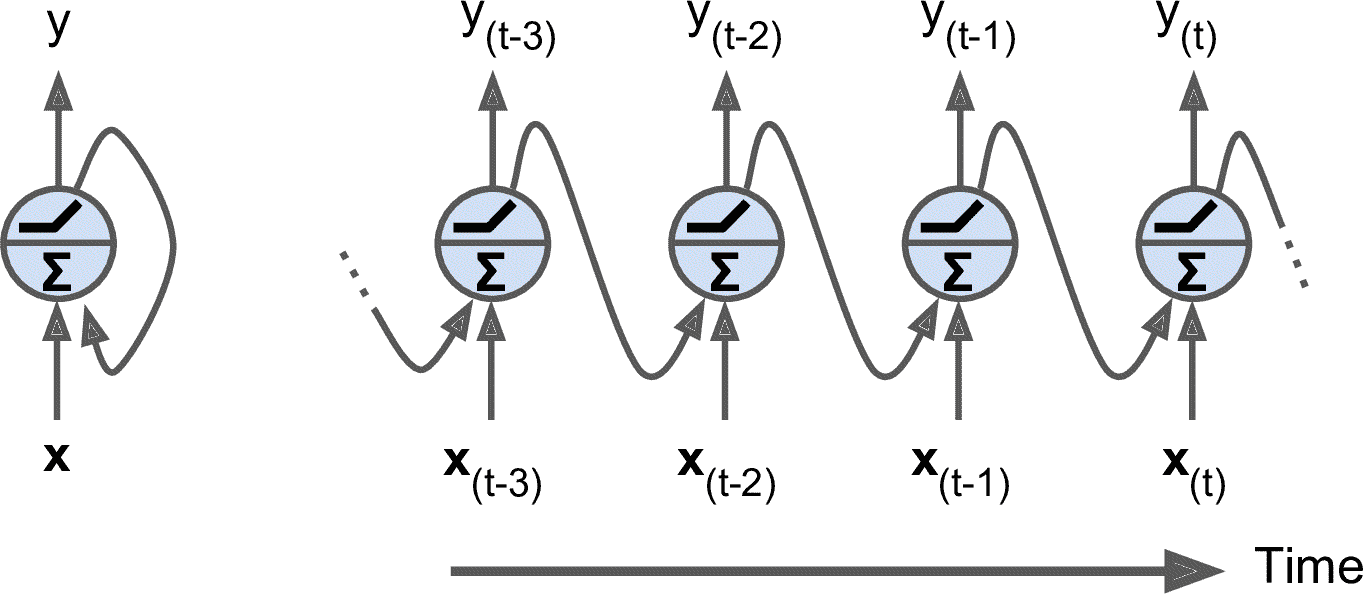
我们主要关注的是前馈神经网络, 激活仅从输入层到输出层的一个方向流动( 附录 E 中的几个网络除外) 。 循环神经网络看起来非常像一个前馈神经网络, 除了它也有连接指向后方。 让我们看一下最简单的 RNN, 由一个神经元接收输入, 产生一个输出, 并将输出发送回自己, 如图 15-1( 左) 所示。
每个循环神经元有两组权重: 一组用于输入x[t], 另一组用于前一时间步长y[t - 1]的输出。 我们称这些权重向量为w[x]和w[y]。 如果考虑的是整个循环神经元层, 可以将所有权重向量放到两个权重矩阵中, W[x]和W[y]。 整个循环神经元层的输出可以用公式 15-1 表示( b是偏差项, φ(·)是激活函数, 例如 ReLU) 。
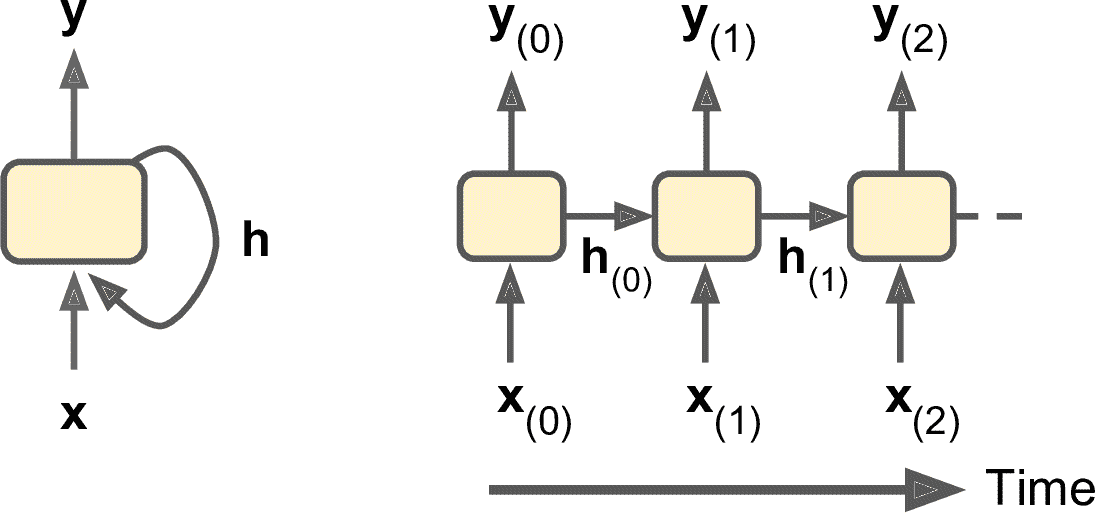
一般情况下, 时间步t的单元状态, 记为h[t]( h代表“ 隐藏” ) , 是该时间步的某些输入和前一时间步状态的函数: h[t] = f(h[t - 1], x[t])。 其在时间步t的输出, 表示为y[t], 也和前一状态和当前输入的函数有关。
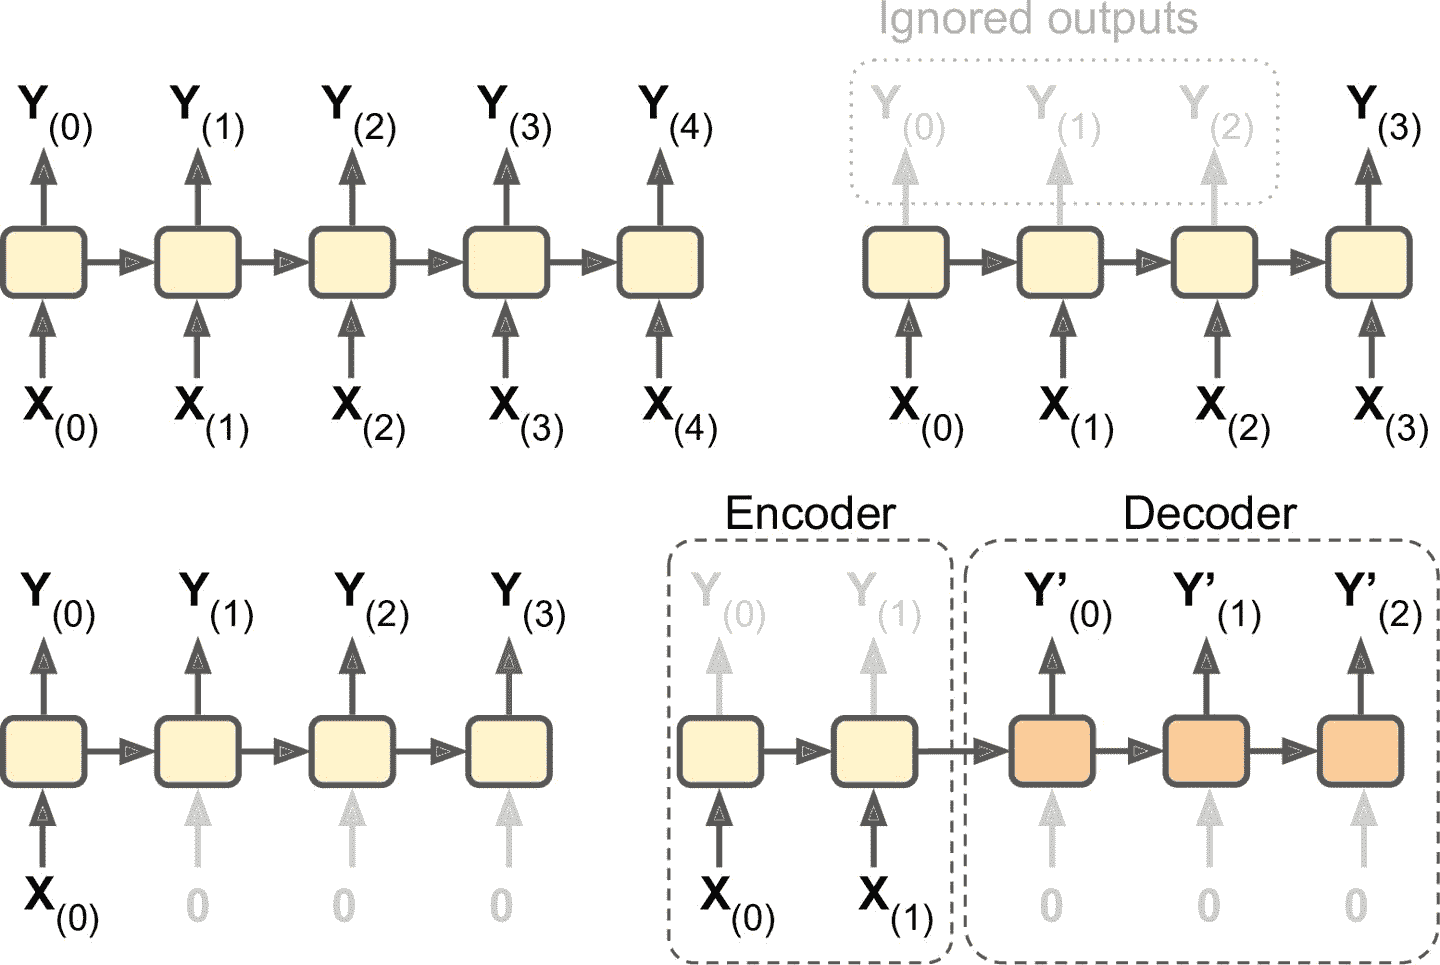
RNN 可以同时输入序列并输出序列( 见图 15-4, 左上角的网络) 。 这种序列到序列的网络可以有效预测时间序列( 如股票价格) : 输入过去N天价格, 则输出向未来移动一天的价格( 即, 从N - 1天前到明天) 。
或者, 你可以向网络输入一个序列, 忽略除最后一项之外的所有输出( 图 15-4 右上角的网络) 。 换句话说, 这是一个序列到向量的网络。 例如, 你可以向网络输入与电影评论相对应的单词序列, 网络输出情感评分( 例如, 从-1 [讨厌]到+1 [喜欢]) 。
相反, 可以向网络一遍又一遍输入相同的向量( 见图 15-4 的左下角) , 输出一个序列。 这是一个向量到序列的网络。 例如, 输入可以是图像( 或是 CNN 的结果) , 输出是该图像的标题。
给网络输入一种语言的一句话, 编码器会把这个句子转换成单一的向量表征, 然后解码器将这个向量解码成另一种语言的句子。 这种称为编码器 - 解码器的两步模型, 比用单个序列到序列的 RNN 实时地进行翻译要好得多, 因为句子的最后一个单词可以影响翻译的第一句话, 所以你需要等到听完整个句子才能翻译。 第 16 章还会介绍如何实现编码器-解码器( 会比图 15-4 中复杂)
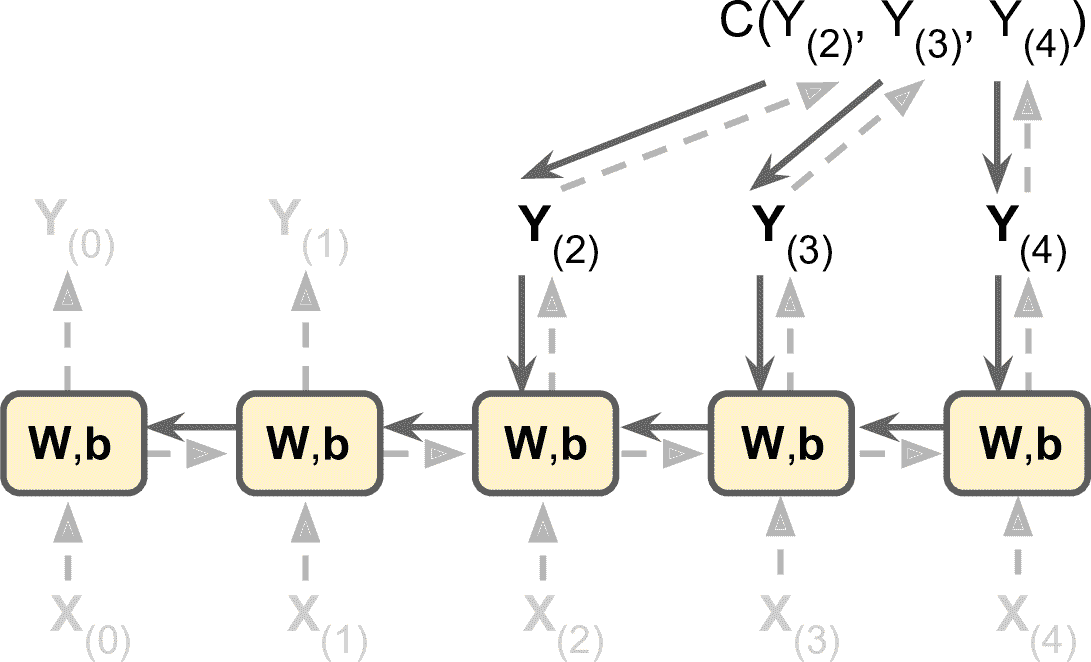
训练 RNN 诀窍是在时间上展开( 就像我们刚刚做的那样) , 然后只要使用常规反向传播( 见图 15-5) 。 这个策略被称为时间上的反向传播( BPTT) 。
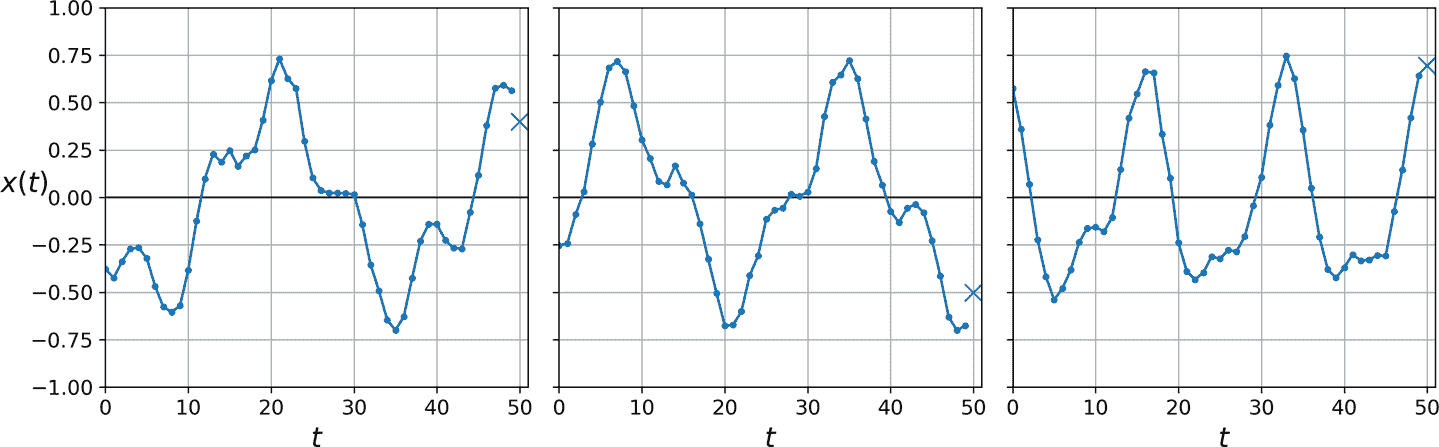
假设你在研究网站每小时的活跃用户数, 或是所在城市的每日气温, 或公司的财务状况, 用多种指标做季度衡量。 在这些任务中, 数据都是一个序列, 每步有一个或多个值。 这被称为时间序列。
使用 RNN 之前, 最好有基线指标, 否则做出来的模型可能比基线模型还糟。 例如, 最简单的方法, 是预测每个序列的最后一个值。 这个方法被称为朴素预测, 有时很难被超越。 在这个例子中, 它的均方误差为 0.020:
另一个简单的方法是使用全连接网络。 因为结果要是打平的特征列表, 需要加一个Flatten层。 使用简单线性回归模型, 使预测值是时间序列中每个值的线性组合:
>>> y_pred = X_valid[:, -1 ]>>> np.mean(keras.losses.mean_squared_error(y_valid, y_pred))0.020211367 model = keras.models.Sequential([ keras.layers.Flatten(input_shape=[50 , 1 ]), keras.layers.Dense(1 ) ]) model = keras.models.Sequential([ keras.layers.SimpleRNN(1 , input_shape=[None , 1 ]) ])
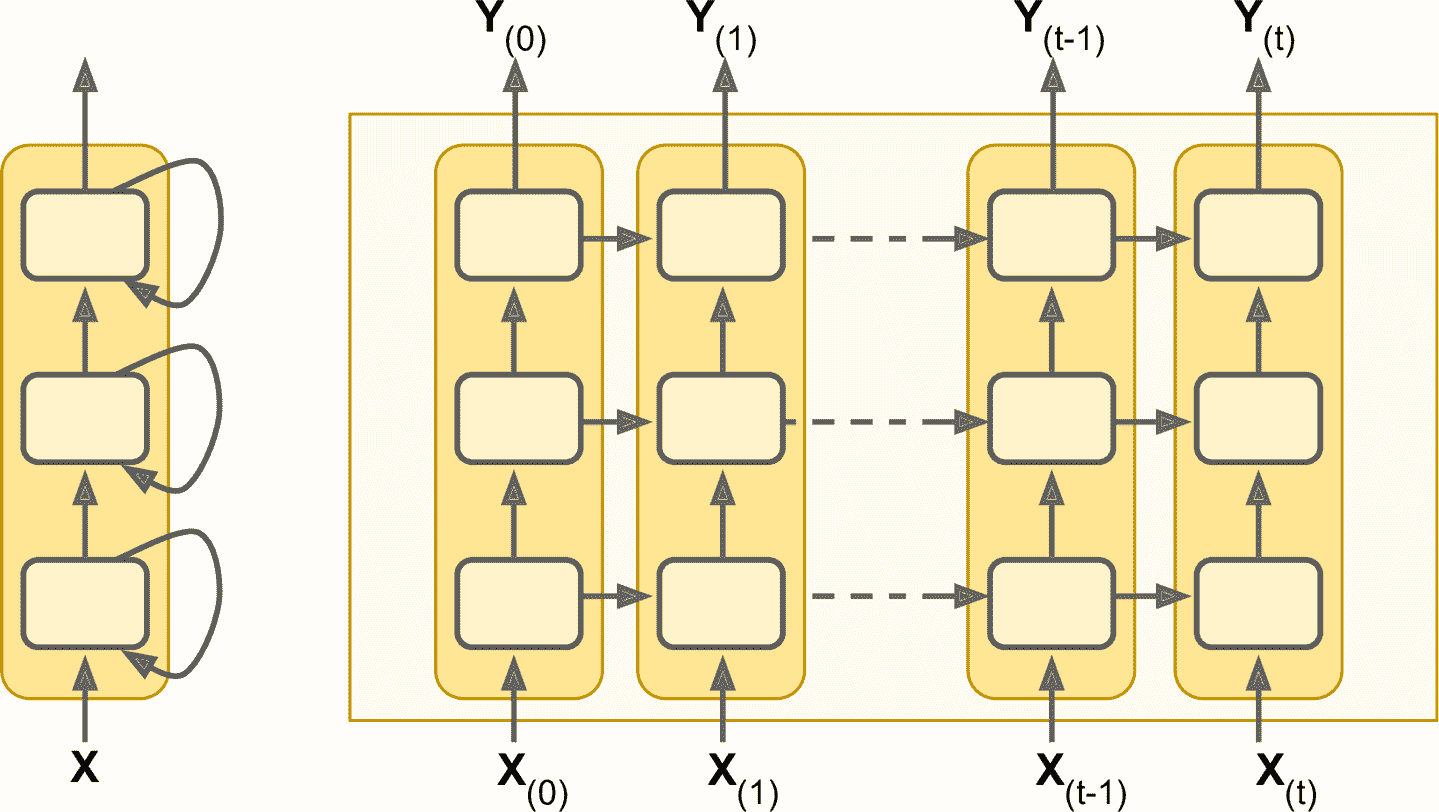
将多个神经元的层堆起来, 见图 15-7。 就形成了深度 RNN。
在训练长序列的 RNN 模型时, 必须运行许多时间步, 展开的 RNN 变成了一个很深的网络。 正如任何深度神经网络一样, 它面临不稳定梯度问题( 第 11 章讨论过) , 使训练无法停止, 或训练不稳定。 另外, 当 RNN 处理长序列时, RNN 会逐渐忘掉序列的第一个输入。 下面就来看看这两个问题, 先是第一个问题。
很多之前讨论过的缓解不稳定梯度的技巧都可以应用在 RNN 中: 好的参数初始化方式, 更快的优化器, 丢弃, 等等。 但是非饱和激活函数( 如 ReLU) 的帮助不大; 事实上, 它会导致 RNN 更加不稳定。 为什么呢? 假设梯度下降更新了权重, 可以令第一个时间步的输出提高。 因为每个时间步使用的权重相同, 第二个时间步的输出也会提高, 这样就会导致输出爆炸 —— 不饱和激活函数不能阻止这个问题。 要降低爆炸风险, 可以使用更小的学习率, 更简单的方法是使用一个饱和激活函数, 比如双曲正切函数( 这就解释了为什么 tanh 是默认选项) 。
另外, 批归一化也没什么帮助。 事实上, 不能在时间步骤之间使用批归一化, 只能在循环层之间使用。 更加准确点, 技术上可以将 BN 层添加到记忆单元上( 后面会看到) , 这样就可以应用在每个时间步上了( 既对输入使用, 也对前一步的隐藏态使用) 。 使用tf.keras在一个简单记忆单元中实现层归一化。 另一种归一化的形式效果好些: 层归一化。 它是由 Jimmy Lei Ba 等人在 2016 年的一篇论文 中提出的: 它跟批归一化很像, 但不是在批次维度上做归一化, 而是在特征维度上归一化。 这么做的一个优势是可以独立对每个实例, 实时计算所需的统计量。 这还意味着训练和测试中的行为是一致的( 这点和 BN 相反) , 且不需要使用指数移动平均来估计训练集中所有实例的特征统计。
由于数据在 RNN 中流动时会经历转换, 每个时间步都损失了一定信息。 一定时间后, 第一个输入实际上会在 RNN 的状态中消失。